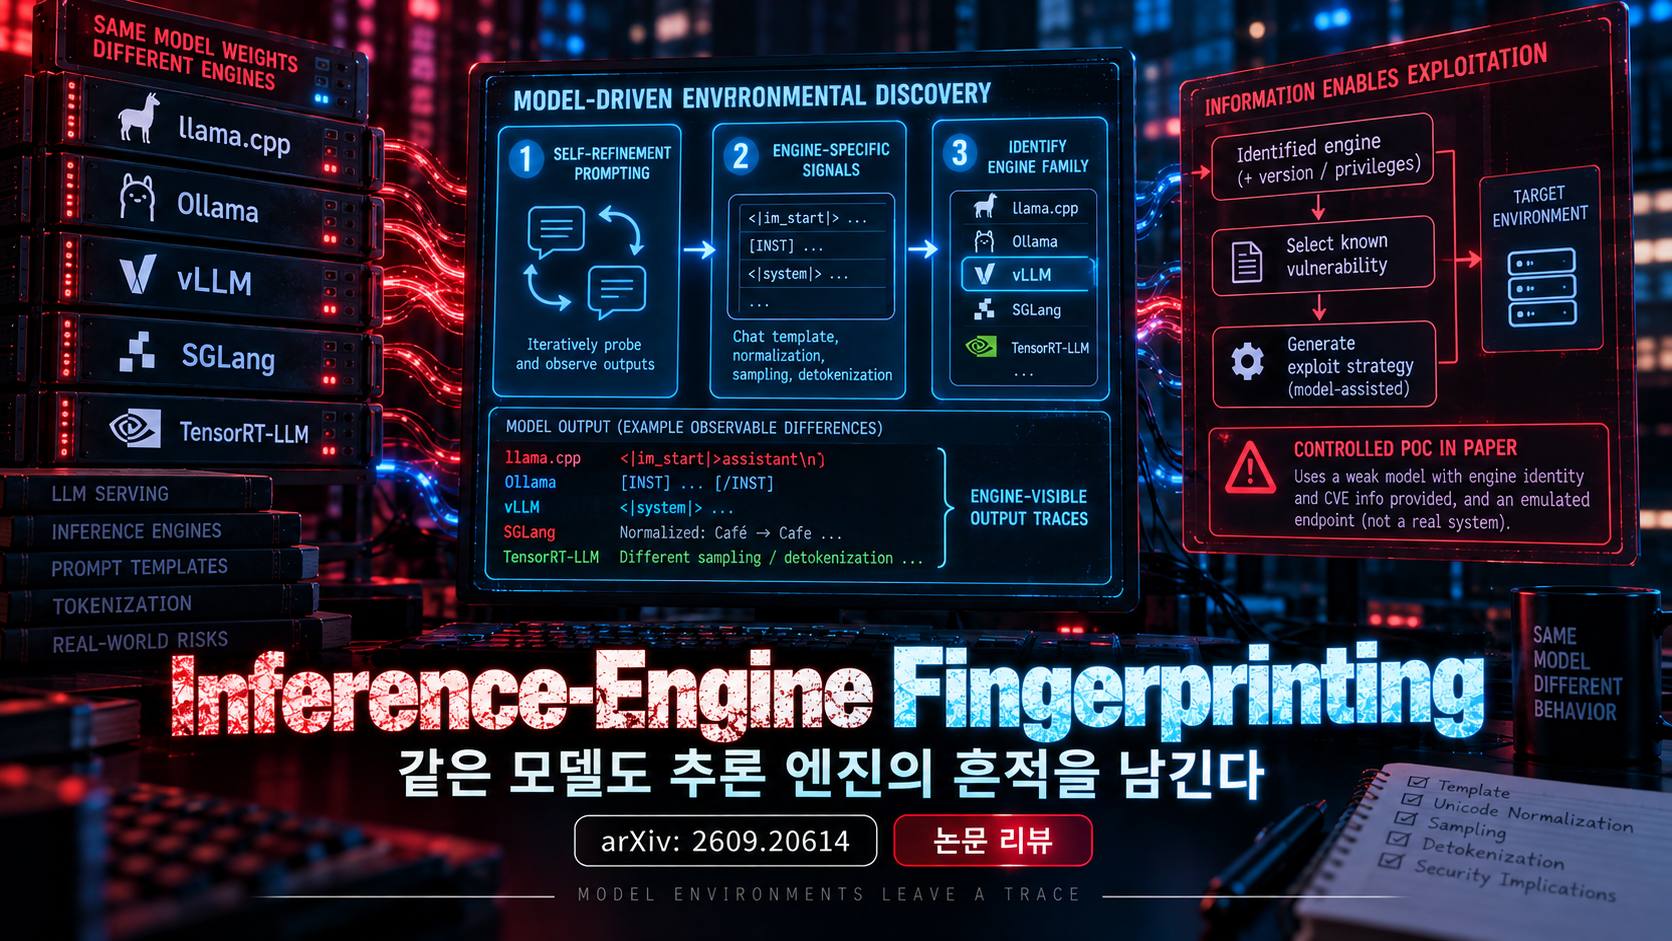
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv 2609.20614
- 저자: Sarah Radway, Andrew Cheng, Vijay Janapa Reddi, James Mickens
- 공개일: 2026-09-17 (arXiv v1)
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
같은 model weight를 써도 llama.cpp, Ollama, vLLM, SGLang, TensorRT-LLM은 chat template, Unicode normalization, sampling, detokenization 차이를 model-visible 출력으로 남긴다. 논문은 model이 세 단계 self-refinement prompt로 이 차이를 유도·관찰해 serving engine family를 식별할 수 있고, 특정 엔진·버전·권한 조합에서는 알려진 취약점 선택에 이 정보를 사용할 수 있음을 보인다.
다만 제목보다 입증 범위는 좁다. fingerprint signal은 다섯 엔진에서 반복 관찰됐지만 end-to-end exploit chain은 약한 Qwen 모델에게 engine identity와 CVE 정보를 system prompt로 미리 알려주고, 강한 Opus 4.8이 exploit을 작성하는 과도하게 유도된 controlled PoC다. 최종 BMC 단계도 실제 취약 AWS firmware가 아니라 emulated endpoint였다.
연구 배경
LLM serving engine은 model API 뒤에 숨지만 입력 전처리와 출력 후처리를 담당한다. 같은 prompt라도 template의 system date, tokenizer의 Unicode 정규화, repetition penalty 구현, special token detokenization이 다르면 model output에 engine-specific signal이 생긴다.
공격자는 engine을 알면 공개 CVE나 잘못된 container privilege와 맞는 공격 경로를 좁힐 수 있다. 전통적인 network banner가 없어도 model 자체가 환경 탐색 probe와 결과 해석을 수행할 수 있다는 것이 연구의 출발점이다.
공격 모델 / 전제 조건
공격자는 target LLM에 prompt를 보낼 수 있고 여러 응답을 비교할 수 있다. 강한 조건에서는 model이 자기 출력으로 parser·tool path에 영향을 주며, serving process가 취약 버전과 과도한 OS·container 권한으로 실행된다.
fingerprinting 자체에는 host credential이 필요 없지만 exploit에는 정확한 engine version, 취약 code path, tool parser 활성화, container capability, host configuration이 모두 맞아야 한다. 논문의 chain은 실험 환경을 통제하고 model에 CVE 정보를 명시적으로 제공했다.
비판적 검토 / 아쉬운 점
첫째, realistic chain이 engine 발견부터 exploit 선택까지 자율적으로 이어졌다고 보기 어렵다. system prompt가 Qwen에게 engine identity와 CVE 목록을 알려주고 Opus 4.8이 exploit을 생성했다. fingerprint 결과만 받은 단일 공격 model이 unknown target을 식별·검증·악용하는 blind test가 필요하다.
둘째, 다중 sample 95% 계산은 probe 오류가 독립이라는 가정에 의존하지만 batching, hardware, concurrent load, deterministic template 같은 공통 원인은 독립이 아니다. 실제 remote service에서 시간·부하를 바꾼 반복 측정과 calibration이 필요하다.
셋째, 최종 bare-metal 단계는 affected MegaRAC BMC가 없는 AWS 환경에서 emulated agent traffic을 성공으로 취급했다. 따라서 “cloud host escape 실증”보다 “가정된 취약 management endpoint까지 chain 연결”이 정확하다. 실제 firmware에서의 승인된 재현이나 vendor disclosure가 있어야 마지막 경로가 입증된다.
핵심 Root Cause
첫 번째 깨진 불변조건은 “model API가 backend 구현 identity를 숨긴다”이다. engine별 template·normalization·sampling·detokenization semantics가 model이 관찰 가능한 결과에 일관되게 반영되어, 동일 weight 위에 식별 가능한 behavioral surface가 생긴다.
두 번째는 “model output과 serving infrastructure는 권한 경계로 분리된다”이다. 실제로 tool parser·detokenizer·runtime이 model 생성 token을 고권한 code path에 넣고, serving process가 container escape에 필요한 capability까지 가지면 환경 정보가 exploit 선택으로 이어진다.
핵심 공격 원리
probe는 model에게 특정 behavior를 유도하고, 결과 signal을 텍스트로 추출한 뒤, 알려진 engine signature와 매칭한다. 예를 들어 llama-3.1 template의 system date 처리, Qwen tokenizer의 NFD Korean 정규화, repetition penalty가 첫 글자 대문자 반복에 미치는 차이를 사용한다.
논문은 self-refinement를 “행동 유도→signal 추출→engine family 판정”의 세 prompt로 나눈다. 이후 proof-of-concept는 식별된 환경에 맞는 알려진 parser 취약점, 과도한 container capability, management endpoint 취약점을 순서대로 연결한다.
공격 흐름
- 공격자가 동일 model endpoint에 engine-sensitive prompt를 보낸다.
- model이 date, Unicode, repetition behavior 같은 signal을 출력한다.
- 후속 prompt가 signal을 정규화하고 candidate engine family를 고른다.
- 여러 sample을 모아 노이즈를 줄이고 버전·기능 조건을 추정한다.
- 승인된 실험 환경에서만 해당 engine의 알려진 취약 code path 존재를 확인한다.
- container·host 경계 조건이 모두 맞는 경우에 한해 영향 범위를 검증한다.
성공 조건 / 실패 조건
fingerprinting 성공에는 engine별 동작 차이가 유지되고 공격자가 충분한 query를 보낼 수 있어야 한다. exploit 성공에는 vLLM 0.10.0의 특정 tool parser 경로, Docker cgroups v1과 CAP_SYS_ADMIN 같은 추가 조건, 마지막 단계의 취약 MegaRAC 환경이 필요하다.
template·tokenizer·sampling semantics를 표준화하고 backend identity signal을 회귀시험하면 fingerprint가 약해진다. 더 중요하게는 parser를 별도 최소권한 process에 두고, rootless container·cgroups v2·capability 제거·VM 격리를 적용하면 engine을 맞혀도 exploit chain이 실패한다.
연구진의 실험 환경
다섯 engine은 llama.cpp b9592, Ollama 0.30.7, vLLM 0.19.1, SGLang 0.5.10.post1, TensorRT-LLM 1.0.0이다. exploit PoC의 vLLM은 별도로 0.10.0을 사용했다. model은 Llama-3.1-8B, Gemma-3-27B-it, GPT-OSS-120B, Qwen3-Coder-30B-A3B이며 H200 GPU와 AMD Genoa CPU의 연구 cluster에서 실행됐다.
세 단계 fingerprint prompt를 engine·model·temperature별 20회 실행했다. 논문은 최대 11개 probe sample이면 독립 noise 가정 아래 temperature 1에서도 95% 신뢰에 도달한다고 계산하지만, 이는 실측 remote independence 결과가 아니다.
주요 실험 결과
system_date probe에서 llama.cpp는 2026년 현재 날짜를, vLLM·SGLang·TensorRT-LLM은 2024-07-26 fallback을 보였고 Ollama는 날짜를 생략했다. Qwen3-Coder의 NFD Korean probe는 llama.cpp·Ollama가 102 token, 나머지 세 엔진이 NFC normalize해 38 token을 사용했다.
repetition penalty 1.5 조건에서 Ollama·SGLang은 소문자 the 반복, llama.cpp·vLLM·TensorRT-LLM은 대문자 The 반복으로 갈렸다. 20회 현실형 self-refinement에서 대체로 signal 존재율은 80% 이상, TensorRT-LLM을 제외한 signal extraction은 temperature 0~0.6에서 75% 이상이었다. TensorRT-LLM의 Qwen 출력은 일부 조건에서 degeneration을 보였다.
실제 발견된 취약점 / 사례
PoC는 vLLM 0.10.0 tool parser의 CVE-2025-9141, Docker cgroups v1 escape 조건의 CVE-2022-0492, AMI MegaRAC의 CVE-2023-34329·CVE-2023-34330을 연결한다. 이는 논문이 새 CVE를 발견했다는 뜻이 아니라 기존 취약점 선택에 fingerprint를 쓰는 시나리오다.
Docker 단계는 CAP_SYS_ADMIN과 cgroups v1이 필요한 취약 구성이다. 연구진의 실제 AWS host는 해당 MegaRAC firmware를 쓰지 않았고, 마지막 단계는 host agent가 예상 traffic을 받으면 성공으로 기록하는 emulator였다.
저자 주장 vs 실제 증명 범위
동일 model이 engine별로 구별되는 signal을 낸다는 주장은 다섯 구현과 여러 model에서 반복 측정됐다. model-driven multi-step prompt가 signal을 유도하고 family를 추론할 수 있다는 것도 controlled 실험에서 뒷받침된다.
반면 완전히 모르는 production endpoint에서 model이 홀로 engine·version을 정확히 찾고 bare metal까지 탈출했다는 주장은 입증되지 않았다. exploitation은 full environment 정보를 prompt에 제공한 multi-model chain이고 마지막 firmware는 emulation이다.
기존 공격 / 기존 점검 방식과의 차이
전통적인 stack fingerprint는 HTTP header, timing, error message처럼 model 바깥의 신호를 본다. 이 연구는 model behavior 자체를 probe surface로 사용해 API가 숨긴 tokenizer·template·sampler 차이를 추론한다.
기존 LLM sandbox 연구가 알려진 취약점의 직접 trigger에 집중했다면, 여기서는 먼저 환경을 식별해 attack selection cost를 줄이는 reconnaissance 단계와 exploit chain을 연결한다.
연구의 한계와 주의해서 볼 부분
다섯 엔진의 특정 version만 평가한 work-in-progress이며 hardware, batching, quantization, wrapper prompt가 바뀌면 signature가 달라진다. nondeterminism과 concurrent load 영향도 체계적으로 측정하지 않았다.
model identity가 알려져 있거나 별도로 맞혀야 signature table을 적용할 수 있다. backend를 맞히는 것과 취약 version·설정을 맞히는 것은 다르며, engine family fingerprint만으로 exploitability를 선언하면 과도한 일반화다.
공개 PoC / Exploit / Tool / Artifact 분석
논문과 2026-09-19 공개 검색에서 저자가 관리하는 공식 code·artifact 저장소를 확인하지 못했다. 부록은 prompt와 구성 설명을 제공하지만, 독립적으로 내려받아 실행할 수 있는 공개 PoC가 검증된 것은 아니다.
CVE는 공개 식별자지만 여기서는 공격 재현 절차가 아니라 방어 조건 확인에 사용해야 한다. 특히 논문의 마지막 단계가 emulator였으므로 공개된 end-to-end cloud escape artifact가 있다고 표현해서는 안 된다.
레드팀 / 모의해킹에서 어떻게 활용할까
자체 serving stack에서 engine-sensitive regression prompt를 돌려 backend identity가 사용자 출력으로 새는지 확인할 수 있다. 관찰 포인트는 template field, Unicode token count, sampler 결과, error·detokenization 차이이며 실제 exploit 대신 version inventory와 hardening state를 대조한다.
fingerprint가 일치해도 취약점 실행으로 넘어가지 않고, parser process 권한·container capability·cgroups mode·VM 경계를 설정 증거로 검증한다. production host나 management controller에 payload를 보내지 않으며 예상치 못한 tool parser 실행이 관찰되면 즉시 중단한다.
실제 점검 시 추가할 체크리스트
- 동일 model의 engine별 template·Unicode·sampling 차이를 회귀시험하는가
- system date와 backend default가 model output에 노출되는가
- 여러 sample의 오류를 독립으로 가정하지 않고 실제 상관을 측정하는가
- engine family와 exact version·feature flag를 구분하는가
- tool parser가 model output을 동적 코드로 해석하지 않는가
- parser·detokenizer가 inference process와 권한 분리되는가
- container가 rootless·cgroups v2이며 불필요한 capability가 제거됐는가
- container escape 뒤에도 VM 경계가 존재하는가
- BMC·management plane이 workload network와 분리되는가
- 알려진 CVE와 실제 배포 version·configuration을 자산 기준으로 대조하는가
실무 가치 평가
중간 이상이다. serving engine을 단순 교체 가능한 backend로 보지 않고 model-visible attack surface로 점검해야 한다는 문제 제기는 유용하다. 다만 exploit chain의 유도 조건과 emulation을 감안하면 위험 평가는 fingerprint 자체보다 parser 최소권한과 container·VM 격리에 집중해야 한다.
결론
model API는 backend 구현을 완전히 숨기지 못하며 작은 semantic 차이도 reconnaissance signal이 될 수 있다. 그러나 identity leakage가 실제 escape가 되려면 취약 version과 과도한 권한이 연속으로 필요하므로, 표준화와 함께 privilege separation·VM 격리가 핵심 방어다.


댓글