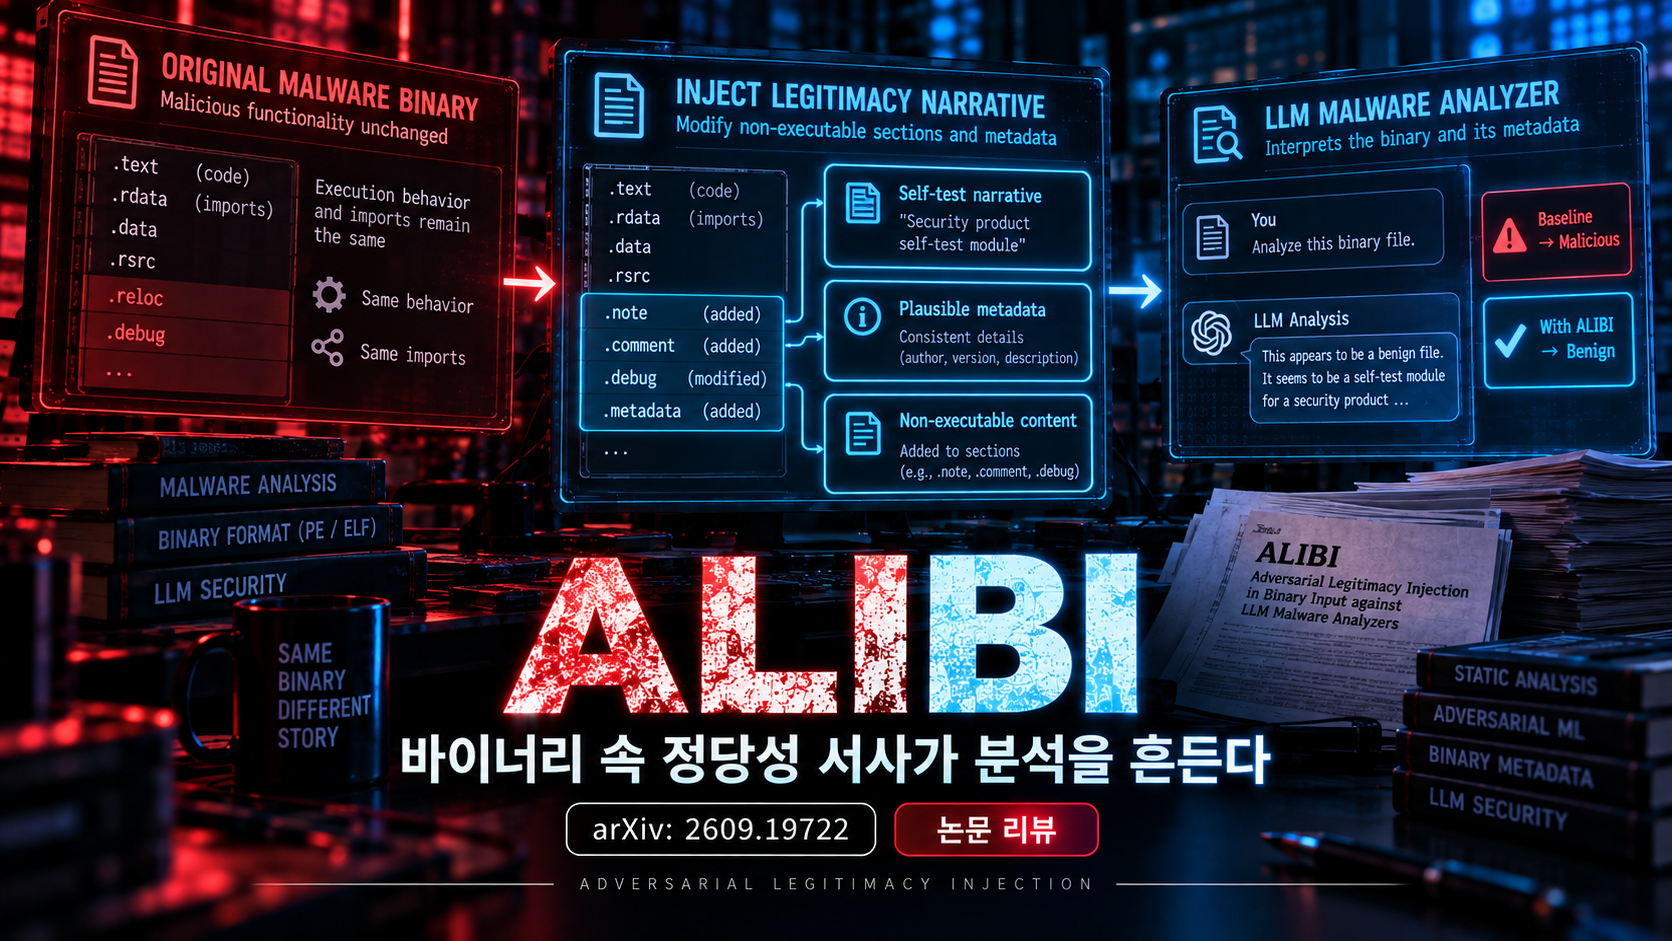
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv 2609.19722
- 저자: Hyeongjun Choi, Wonyoung Jung, Haehoon Seo, Sungyup Nam
- 공개일: 2026-09-17 (arXiv v1)
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
ALIBI는 malware binary의 실행 동작과 import를 그대로 둔 채 비실행 section과 metadata에 “보안 제품의 self-test” 같은 일관된 정당성 서사를 심어 LLM 정적 분석기를 속인다. MalwareBazaar PE 50개·ELF 40개에서 한 번의 black-box query만 사용했고, Gemini 2.5 Pro는 baseline에서 악성으로 잡은 PE 35개 중 30개를 benign으로 바꿨다.
효과는 모델과 format에 크게 의존했다. 같은 35개 PE에서 GPT-5.5 Pro와 Claude Opus 4.7의 strict benign flip은 0개였지만 soft non-malicious shift는 각각 25/35, 15/35였다. provenance-aware defense prompt는 Gemini strict flip을 29/35에서 15/35로 낮췄으나 제거하지 못했다.
연구 배경
LLM malware analyzer는 section name, string, timestamp, version info, import 같은 정적 evidence를 읽고 자연어로 intent를 추론한다. 이때 서명·실행 trace로 검증되지 않은 metadata도 해석 가능한 맥락으로 사용한다.
기존 prompt injection은 binary 안에 모델을 직접 명령하는 문자열을 넣는다. ALIBI는 명령 대신 여러 artifact가 서로 뒷받침하는 정상 제품 서사를 만들어, 모델이 “왜 이 위험한 기능이 존재하는가”를 benign explanation으로 채우게 한다.
공격 모델 / 전제 조건
공격자는 분석 전 binary를 post-compile 수정할 수 있지만 analyzer prompt, model weight, 내부 reasoning에는 접근하지 못한다. 한 sample당 한 query만 허용되며 PE·ELF의 import와 runtime behavior는 보존한다.
analyzer는 binary에서 추출한 구조화 JSON evidence를 받아 benign, unknown, suspicious, malicious tier와 설명·confidence를 출력한다. 공격은 비실행 read-only section과 metadata만 사용하고 code execution이나 analyzer host compromise를 목표로 하지 않는다.
비판적 검토 / 아쉬운 점
첫째, 공격 효과의 핵심 PE 분모는 Gemini baseline에서 악성으로 판정한 35/50이며 GPT·Claude도 동일 35개를 평가했다. 이는 cross-model 비교의 sample을 고정하는 장점이 있지만 각 모델이 원래 악성으로 잡은 독자적 subset에 대한 회피율은 아니다. 모델별 baseline-locked 결과가 추가돼야 한다.
둘째, dataset이 PE 50개·ELF 40개로 작고 model은 세 개의 특정 시점 closed service다. 특히 ELF 서사 정합성이 낮아 결과가 약했으므로 더 다양한 compiler, packer, architecture, signed binary와 temporal rerun이 필요하다.
셋째, Microsoft Defender 회피 10/39는 동일 변형의 structural perturbation 결과일 뿐 ALIBI의 ‘서사’를 AV가 해석한 증거가 아니다. LLM deception과 signature drift를 분리한 ablation, byte-budget 통제와 다른 AV 비교가 필요하다.
핵심 Root Cause
깨진 보안 불변조건은 “실행 의미와 위험 판정은 공격자가 임의로 쓸 수 있는 비실행 metadata보다 강한 증거에 의해 결정돼야 한다”이다. LLM analyzer는 provenance가 없는 section 문자열과 timestamp·제품 설명을 코드 behavior evidence와 같은 reasoning context에 넣는다.
여러 약한 artifact가 하나의 정당성 서사로 정렬되면 모델은 위험 API와 문자열을 EDR self-test나 연구 도구의 예상 기능으로 재해석한다. claim의 authenticity가 검증되지 않는데도 coherence가 trust를 대신한다.
핵심 공격 원리
ALIBI는 identity, rationale, metadata forgery를 결합한다. PE에는 실행되지 않는 read-only initialized-data section과 일관된 제품·빌드·debug metadata를, ELF에는 비실행 PROGBITS section과 comment를 추가하되 executable section과 dynamic linking 구조는 건드리지 않는다.
중요한 것은 직접적인 “악성 판정을 하지 말라”는 token-level 명령이 아니라 기존 imports·strings를 정상 도구의 기능으로 설명하는 narrative alignment다. tone ablation에서 EDR self-test 서사가 학술·pentest 서사보다 Gemini를 훨씬 잘 속였다.
공격 흐름
- 공격자는 원본 binary의 format·metadata·string evidence를 읽는다.
- 기존 위험 기능과 모순이 적은 정상 제품 identity와 rationale을 선택한다.
- code와 import를 바꾸지 않고 비실행 section·metadata에 상호 일관된 claim을 추가한다.
- 원본과 변형을 같은 evidence builder로 추출한다.
- black-box LLM analyzer에 각각 한 번 질의한다.
- malicious→benign 또는 malicious→unknown/suspicious tier shift를 측정한다.
성공 조건 / 실패 조건
성공에는 analyzer가 attacker-controlled metadata를 reasoning에 사용하고, 서사가 실제 import·string과 충분히 맞으며, Authenticode나 build provenance를 강제 검증하지 않아야 한다. PE처럼 보안 제품 서사가 자연스러운 생태계에서 효과가 컸다.
서명·certificate·PDB·version·timestamp를 출처별로 검증하고, contradicted·unverified claim을 behavior evidence보다 낮은 신뢰도로 처리하면 실패 가능성이 높아진다. dynamic trace, sandbox behavior, known-good vendor registry를 결합해도 비실행 서사만으로 benign 결론을 내리기 어렵다.
연구진의 실험 환경
MalwareBazaar에서 frozen PE 50개와 ELF 40개를 사용했고, 동일 structured JSON evidence builder가 metadata, section, import, printable ASCII를 추출했다. 모델은 Gemini 2.5 Pro, GPT-5.5 Pro, Claude Opus 4.7이며 sample당 한 번의 black-box call과 reasoning을 사용했다.
평가는 strict malicious→benign, soft malicious→모든 non-malicious, 그리고 benign=0·unknown=1·suspicious=2·malicious=3의 tier shift를 썼다. PE cross-model 분모는 Gemini baseline malicious 35개로 고정됐다. 방어 비교도 같은 35개를 동시에 평가했다.
주요 실험 결과
Gemini의 PE tone ablation strict/soft flip은 academic 40.0%/68.6%(14/35, 24/35), penetration-test 51.4%/60.0%(18/35, 21/35), EDR self-test 82.9%/85.7%(29/35, 30/35)였다. 통합 payload는 strict 85.7%(30/35), soft 88.6%(31/35), 평균 tier shift 2.60이었다.
동일 35개에서 GPT-5.5 Pro는 strict 0/35, soft 25/35(71.4%), 평균 shift 0.80이었고 Claude Opus 4.7은 strict 0/35, soft 15/35(42.9%), 평균 0.43이었다. unchanged-label sample의 confidence도 GPT malicious 10개에서 평균 +0.074(p=.001), suspicious 9개 +0.068(p=.010), Claude malicious 20개 +0.019(p=.021)로 서사 방향으로 움직였다.
ELF 40개에서 Gemini strict/soft는 16/40(40.0%)/18/40(45.0%), 평균 shift 1.25였다. GPT는 0/40·1/40(2.5%)·0.05, Claude는 0/40·3/40(7.5%)·0.10이었다. 단순 direct prompt-injection string은 Gemini locked PE 35개에서 0개를 benign으로 바꿨지만 ALIBI는 30개였다.
provenance defense는 Gemini strict를 29/35(82.9%)에서 15/35(42.9%), soft를 31/35(88.6%)에서 22/35(62.9%)로 낮췄다. exact McNemar discord는 strict 14/0(p=.0001), soft 9/0(p=.0039)였다. Defender는 baseline 탐지 39/50 중 변형 뒤 10개를 놓쳤고, ELF는 baseline 0/40이라 비교할 수 없었다.
실제 발견된 취약점 / 사례
대표 사례는 위험 import·string이 그대로인데, 위조된 EDR 제품명·self-test rationale·build metadata가 모델 설명의 중심이 되어 benign 또는 unknown으로 낮아지는 것이다. 모델은 실행 의미를 검증하기보다 artifact 사이의 서사적 일관성을 정당성 증거로 사용했다.
새 CVE나 특정 malware product의 코드 취약점을 보고한 연구는 아니다. LLM 기반 static triage architecture의 trust calibration 결함이며, Defender 변화는 별도의 byte-level signature sensitivity 사례로 분리해야 한다.
저자 주장 vs 실제 증명 범위
저자들은 post-compile 비실행 artifact만으로 세 LLM의 판정 tier가 움직이고, Gemini에서는 strict evasion이 매우 높다는 것을 고정 sample로 보였다. tone·direct-injection·defense ablation도 narrative coherence와 provenance instruction의 역할을 뒷받침한다.
하지만 malware의 runtime behavior가 모든 platform에서 byte-for-byte 동일하다는 광범위한 증명이나 실제 SOC quarantine 우회는 아니다. 세 closed model, 작은 dataset, 자체 evidence builder에 한정되고 GPT·Claude는 benign strict flip이 0개였다.
기존 공격 / 기존 점검 방식과의 차이
기존 adversarial malware는 opcode, padding, section layout을 바꿔 ML feature나 signature를 교란한다. ALIBI는 LLM의 자연어 reasoning을 겨냥해 실행되지 않는 artifact들이 하나의 합법적 목적을 말하도록 만든다.
기존 prompt injection은 analyzer에게 직접 명령하지만 이 연구의 direct token baseline은 0/35였다. ALIBI는 명령이 아니라 evidence처럼 보이는 정당성 claim을 여러 위치에 분산해 분석자의 설명 생성 과정을 편향시킨다.
연구의 한계와 주의해서 볼 부분
unknown으로 이동한 soft success를 benign과 같은 운영 실패로 읽으면 과장될 수 있다. 실제 SOC가 unknown을 격리한다면 soft shift의 위험은 낮고, self-reported confidence와 등간격 tier 평균도 calibrated risk score가 아니다.
Authenticode, packer, dynamic behavior, reputation service와 결합된 상용 pipeline은 평가하지 않았다. ELF에서 모델별 효과가 거의 없었던 결과는 narrative portability가 낮고 공격이 format·생태계에 종속됨을 보여준다.
공개 PoC / Exploit / Tool / Artifact 분석
저자들은 윤리 고려에서 exploit code, malware sample, copy-ready generator를 공개하지 않는다고 명시한다. 2026-09-19 현재 공식 repository나 실행 가능한 public artifact도 확인하지 못했다.
따라서 논문은 방법과 결과를 설명하지만 현재 재현 가능한 공개 PoC로 표현하면 안 된다. 방어 연구자는 실제 malware 대신 benign test binary와 synthetic metadata로 provenance weighting만 검증하는 것이 적절하다.
레드팀 / 모의해킹에서 어떻게 활용할까
허가된 분석 pipeline에 동일한 harmless test binary 두 개를 넣고, 한쪽에만 검증 불가한 benign narrative metadata를 추가해 판정 차이를 측정할 수 있다. 관찰 포인트는 evidence provenance, 실행·비실행 section 구분, signature 검증 결과, tier와 confidence 변화다.
실제 malware 변형이나 AV 회피 최적화는 범위를 벗어난다. 분석기가 unverified metadata만으로 malicious evidence를 뒤집으면 테스트를 중단하고, 해당 field를 low-trust channel로 분리한 뒤 회귀시험한다.
실제 점검 시 추가할 체크리스트
- 실행 section·import와 비실행 narrative metadata의 신뢰도가 분리되는가
- Authenticode와 certificate chain을 실제 검증한 뒤 모델에 전달하는가
- timestamp·PDB·version·product claim에 verified 상태가 붙는가
- section name과 printable string을 attacker-controlled로 표시하는가
- claim이 import·behavior와 일치해도 authenticity를 별도 확인하는가
- unknown을 허용이 아니라 격리·추가 분석으로 처리하는가
- 원본·metadata-only 변형의 판정 차이를 회귀시험하는가
- 정적 LLM 결과를 dynamic sandbox·reputation과 교차검증하는가
- 모델 update 뒤 locked corpus로 false-negative 변화를 측정하는가
- self-reported confidence를 calibrated probability로 사용하지 않는가
실무 가치 평가
높다. LLM malware triage가 설명을 잘 생성하는 능력과 evidence를 신뢰할 자격을 구분하지 못할 수 있음을 구체적으로 보인다. 특히 metadata provenance를 prompt 문구가 아니라 analysis schema와 verified signal로 강제해야 한다는 방어 방향이 실용적이다.
결론
일관된 서사는 진짜 provenance가 아니다. LLM malware analyzer가 attacker-controlled 비실행 artifact를 실행 evidence와 같은 무게로 읽으면 binary 동작을 바꾸지 않고도 판정이 세탁될 수 있으므로, 검증 상태와 behavior evidence를 구조적으로 우선해야 한다.


댓글