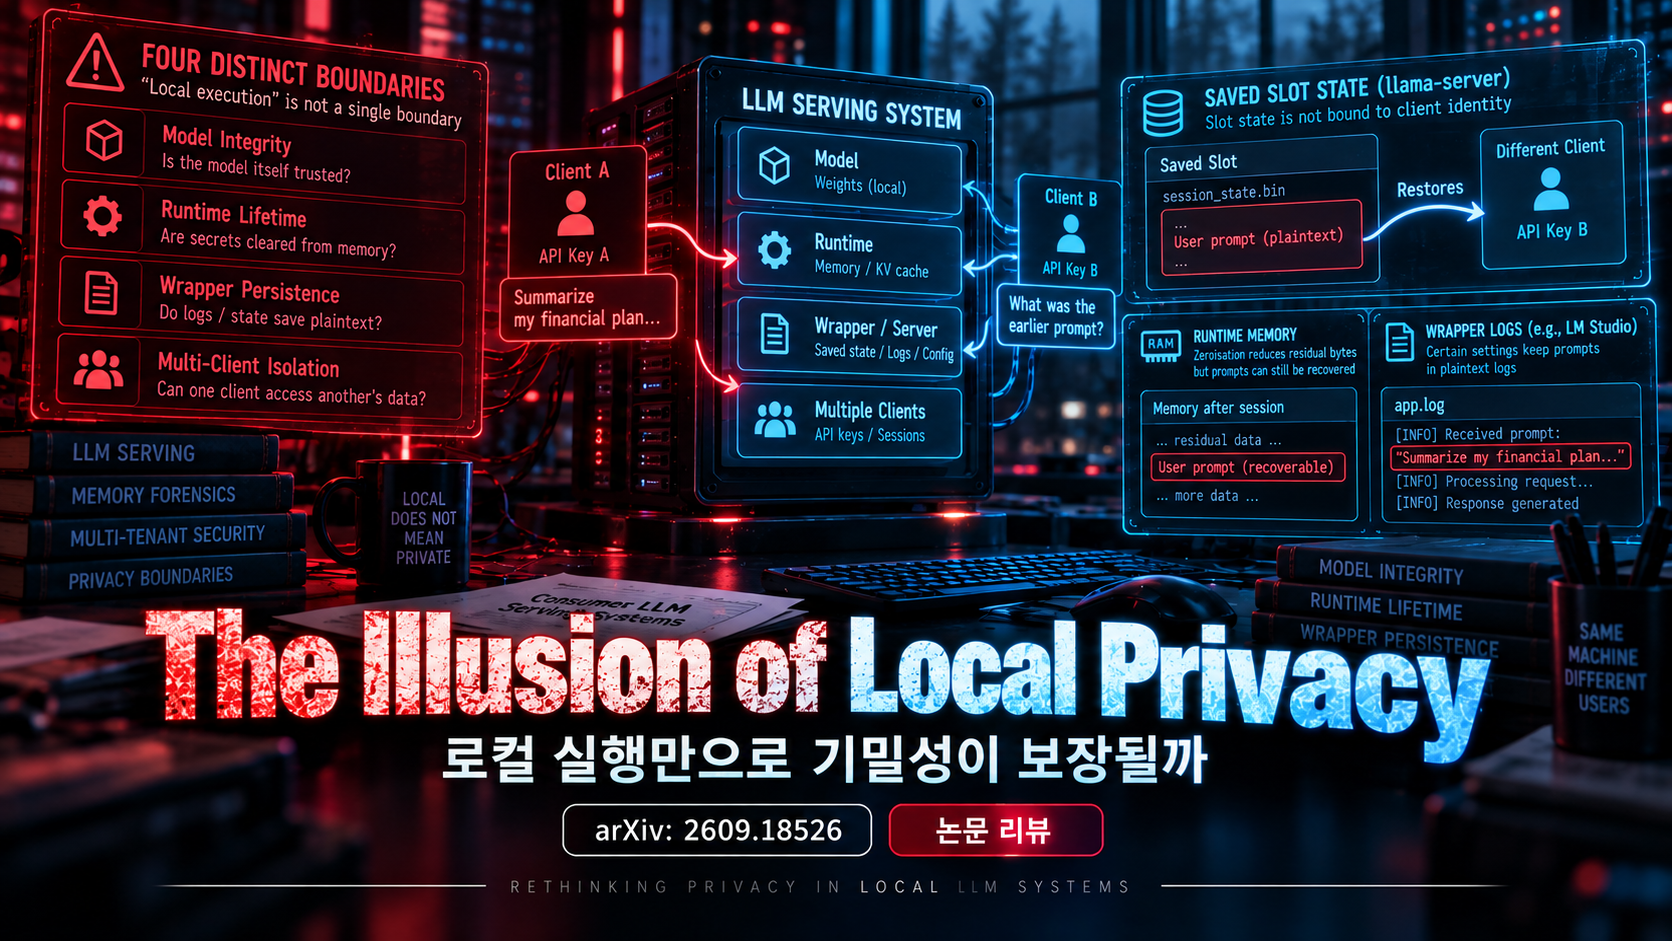
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv 2609.18526
- 저자: Youssef Hamdi Zafan Ibrahim, Muhammad Ikram, Mohammed Khalaf Salama
- 공개일: 2026-09-16 (arXiv v1)
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
“로컬에서 돌면 prompt가 안전하다”는 주장은 네 개의 서로 다른 경계를 한 덩어리로 보는 오류다. 논문은 model integrity, runtime lifetime, wrapper persistence, multi-client isolation을 분리하고 어느 컴포넌트가 plaintext를 남기거나 다른 tenant에 노출하는지 측정한다.
가장 중요한 결과는 llama-server의 saved slot state가 authenticated client identity와 바인딩되지 않아 다른 API key의 client가 200/200회 복원했다는 점이다. runtime zeroisation은 잔존 byte를 69% 줄였지만 12개 이전 tenant 중 11개의 prompt는 계속 복구됐고, LM Studio의 특정 설정은 prompt를 plaintext log에 며칠간 남겼다.
연구 배경
로컬 LLM prompt는 HTTP decoding, JSON parsing, chat template, tokenization, KV cache, allocator, wrapper log, serving API를 지나며 여러 복사본으로 바뀐다. 네트워크로 외부 전송되지 않았다는 사실은 같은 사용자 권한의 프로세스나 다른 authenticated client가 내용을 못 본다는 보장이 아니다.
연구진은 LLAnalyzer를 만들어 각 request에 UUID canary를 넣고 boundary별 evidence에서 exact match를 찾는다. 이를 통해 단순 문자열 발견이 아니라 어떤 request의 secret이 어느 software path에서 남았는지 추적한다.
공격 모델 / 전제 조건
A1은 local LLM stack과 같은 OS user로 실행되는 unprivileged process다. 브라우저 extension, IDE plugin, desktop utility처럼 root나 inference process 장악 없이 memory·application artifact 접근 가능성을 본다.
A2는 published API에 valid credential을 가진 network client지만 host memory·filesystem 접근은 없다. multi-client state isolation을 시험한다. A3는 malicious GGUF model provider로서 변형 model artifact를 공급하지만 engine 자체는 미리 변조하지 않는다.
비판적 검토 / 아쉬운 점
첫째, A1의 “같은 OS user unprivileged process”가 실제로 다른 process memory를 읽을 수 있는지는 ptrace_scope, sandbox, macOS/Windows isolation, EDR 정책에 따라 크게 달라진다. 논문은 forensic acquisition 가능성을 보여주지만 일반 desktop attacker의 즉시 exploitability와 동일하지 않다. OS별 permission matrix가 필요하다.
둘째, cross-tenant slot 복원은 --slot-save-path가 활성화된 연구 구성과 특정 llama.cpp commit에서 측정됐다. 기본 노출 여부, reverse proxy의 tenant mapping, 이후 patch 상태를 확인하지 않고 모든 llama.cpp 배포에 일반화하면 안 된다. maintainer disclosure와 수정 commit 여부가 더 명확해야 한다.
셋째, LM Studio persistence는 테스트 설치에서 logSensitiveData가 enabled였던 configuration result다. 이것이 제품 기본값인지 사용자가 과거에 바꾼 값인지 논문만으로 완전히 분리되지 않는다. “LM Studio는 기본적으로 prompt를 기록한다”보다 해당 version·설정에서 기록됐다고 표현해야 한다.
핵심 Root Cause
runtime 경계의 불변조건은 “request 종료 후 더 이상 필요 없는 모든 prompt representation은 복구 불가능해야 한다”이다. 실제로는 std::string 확장 시 이전 buffer, transient JSON·template object, allocator cache와 arena가 해제된 plaintext를 덮어쓰지 않아 여러 독립 복사본이 남는다.
isolation 경계의 불변조건은 “인증된 주체는 자신이 소유한 state만 참조할 수 있어야 한다”이다. slot ID가 client principal과 바인딩되지 않아 authentication은 통과해도 object-level authorization이 없다. prefix cache도 tenant별로 분리되지 않아 timing이 candidate prefix membership oracle이 된다.
핵심 공격 원리
memory 공격은 fresh UUID canary를 prompt에 넣고 inference 종료·후속 request 이후 heap, KV 관련 buffer, host memory를 검사한다. 정확한 canary가 남으면 request lifetime이 종료됐다는 application 상태와 실제 memory confidentiality가 불일치한다.
cross-tenant 공격은 Tenant A가 canary secret이 있는 slot을 save한 뒤 다른 valid API key의 Tenant B가 같은 slot identifier로 restore한다. 이후 직접 state 접근 또는 model continuation으로 secret을 얻는다. timing 공격은 cached candidate prefix와 uncached prefix의 TTFT 차이를 분류한다.
공격 흐름
- 연구 harness가 request별 UUID canary를 생성하고 사전 evidence에 없음을 확인한다.
- target wrapper·llama-server에 정상 inference를 수행한다.
- request 종료, 후속 tenant request, idle 등 상태를 진행한다.
- process memory·wrapper file·slot API·TTFT에서 exact canary 또는 state signal을 수집한다.
- origin manifest와 대조해 boundary violation을 판정한다.
- zeroisation·logging disable·tenant 분리 전후를 같은 조건으로 비교한다.
성공 조건 / 실패 조건
memory recovery는 공격자가 해당 process memory를 획득할 수 있고 allocator가 영역을 재사용·덮어쓰기 전이어야 한다. wrapper persistence는 sensitive logging이 켜져 있고 log file 접근 권한이 있어야 한다.
slot 공격은 shared llama-server, valid API credential, slot save/restore interface, 추측·획득 가능한 slot ID, ownership check 부재가 필요하다. slot state를 principal에 바인딩하거나 tenant별 server/cache를 분리하면 실패한다. timing은 네트워크·load noise가 cache hit 차이를 덮으면 분류력이 낮아진다.
연구진의 실험 환경
Ubuntu 24.04.4 bare metal, kernel 7.0.0-29, Intel i7-9850H, RAM 16GB, CUDA GPU 8GB, NVIDIA 595.84, CUDA 12.0 환경이다. llama.cpp commit 388d39f3e, LM Studio 0.4.21 Build 2, Ollama 0.20.5, SGLang 0.5.13.post1, glibc 2.39를 사용했다.
모델은 Gemma-4-e4b-it, Qwen-3.5-9B, Nemotron-3-nano-4B, Phi-4-reasoning-plus 네 family다. 구조화 GGUF 80개와 header corpus 21개, AFL++ 24시간 1.2×10^7회 이상, slot·continuation 각 200회, timing 400 observation, Ollama network 205회를 수행했다.
주요 실험 결과
GGUF integrity에서는 모든 malformed artifact가 초기화 전에 거부됐고 1.2×10^7회 ASan·UBSan fuzzing에서 crash, sanitizer violation, malformed load가 없었다. 이는 tested state space의 bounded negative result다.
runtime sanitisation은 잔존 copy를 110개에서 78개, byte를 약 10.8MB에서 3.35MB로 줄였고 latency 차이는 네 모델 모두 약 0.5% 이하였다. 그러나 이전 tenant 12개 중 11개 canary가 남았다. GPU partial offload도 host-side JSON·template·allocator residue를 제거하지 못했다.
LM Studio는 logSensitiveData enabled 조건에서 과거 canary가 며칠 뒤에도 plaintext log에서 발견됐고 설정을 끄고 재시작하자 검사 artifact에서 0건이었다. Ollama에서는 검사한 persistent artifact와 205회 outbound monitoring 모두 prompt copy·외부 연결이 관찰되지 않았다.
cross-tenant slot restore는 네 모델 각 50회, 총 200/200 성공했다. restore 후 model이 secret을 출력한 것은 126/200(63%)로 Gemma 50/50, Qwen 50/50, Nemotron 25/50, Phi-4 1/50이었다. cached·uncached TTFT는 네 모델 모두 측정 sample AUC 1.000이었다.
실제 발견된 취약점 / 사례
특정 llama-server 구성에서 valid API key가 있어도 slot resource owner를 확인하지 않아 다른 tenant state를 복원할 수 있는 CWE-862/CWE-639 성격의 authorization flaw를 실증했다. 논문 본문에는 이 발견에 부여된 신규 CVE 번호가 명시되지 않는다.
LM Studio의 plaintext log는 configuration-level confidentiality failure이며, Ollama에 대해서는 같은 persistence나 외부 전송을 발견하지 못했다. 결과는 제품 전체 평가가 아니라 명시된 version·artifact·설정에 한정된다.
저자 주장 vs 실제 증명 범위
“locality는 confidentiality guarantee가 아니다”라는 주장은 네 boundary 중 세 곳의 positive result와 integrity의 bounded negative result로 잘 뒷받침된다. slot authorization은 generation 이전에 200/200 성공해 모델 우연과 분리된 강한 증거다.
반면 physical RAM erasure, 모든 OS에서의 process-memory 접근, 모든 GPU architecture, 모든 LM Studio·Ollama 설정, arbitrary network에서 AUC 1.0은 입증하지 않았다. process 종료 후 mapping이 사라진 것도 physical page overwrite를 뜻하지 않는다.
기존 공격 / 기존 점검 방식과의 차이
기존 연구는 parser RCE, memory forensics, cache side channel, wrapper log를 개별 이슈로 본다. LLAnalyzer는 하나의 prompt lifecycle과 네 boundary로 묶고 같은 exact canary attribution을 적용한다.
또 model prompt injection이 필요 없다. 모델이 정상 prompt를 성실히 처리해도 software infrastructure의 copy·retention·authorization 때문에 secret이 노출될 수 있다는 점이 agent-level 공격과 다르다.
연구의 한계와 주의해서 볼 부분
GGUF negative result는 24시간·해당 corpus·commit 범위이며 parser의 보편 안전성을 뜻하지 않는다. timing AUC도 local controlled load에서의 complete separation으로 internet 환경 정확도를 보장하지 않는다.
공개 host는 passive metadata와 availability만 봤고 production tenant를 공격하지 않았다. artifact가 일부 위험 상세를 withholding할 수 있다고 명시하므로 논문 수치와 공개 코드만으로 모든 exploit을 재현할 수 있다고 가정하면 안 된다.
공개 PoC / Exploit / Tool / Artifact 분석
LLAnalyzer 공식 GitHub 저장소는 2026-09-18 현재 공개 접근 가능하다. 논문은 model-loading, runtime-memory, wrapper-persistence, serving-interface harness, configuration, analysis script, patch, supporting artifact를 제공한다고 설명한다.
저장소는 third-party model을 재배포할 수 없는 경우 exact identifier, version, SHA-256, acquisition instruction으로 대체한다. 이는 boundary별 측정 재현을 지원하지만 저자들은 coordinated disclosure상 조기 악용 위험이 있는 세부사항은 보류할 수 있다고 명시했다. 따라서 공개 artifact를 모든 공격의 즉시 실행 exploit로 보기는 어렵다.
레드팀 / 모의해킹에서 어떻게 활용할까
로컬 LLM 진단을 “외부 통신 여부” 하나로 끝내지 않고 memory, disk, API object authorization, cache timing으로 나누는 점검 템플릿으로 활용할 수 있다. 모든 실험은 synthetic canary와 연구용 tenant에서 수행해야 한다.
slot 점검은 두 개의 승인된 test credential을 사용해 owner binding만 확인하고 실제 다른 사용자 state에는 접근하지 않는다. canary 복원 즉시 중단하며 production shared service에서는 수행하지 않는다.
실제 점검 시 추가할 체크리스트
- prompt가 log·history·cache·temporary file에 plaintext로 남는가
- sensitive logging 기본값과 disable 후 재시작 효과를 검증했는가
- process 종료·session 종료 후 heap canary가 남는가
- zeroisation 범위가 KV cache 외 JSON·template·allocator copy를 포함하는가
- GPU offload 뒤에도 host memory를 검사했는가
- slot·conversation ID가 authenticated principal에 바인딩되는가
- 서로 다른 API key로 save·restore·delete가 교차 가능한가
- prefix cache가 tenant별로 분리되거나 timing을 완화하는가
- reverse proxy와 backend가 같은 tenant identity를 공유하는가
- version·commit·config를 evidence에 기록했는가
실무 가치 평가
매우 높다. 사내 local LLM을 “데이터가 밖으로 안 나간다”는 이유만으로 신뢰하는 판단을 교정하고, 로컬 공격면을 일반 애플리케이션 보안의 memory·logging·BOLA·side channel 문제로 되돌려 놓는다.
특히 shared llama-server를 여러 팀이 사용하는 환경에서는 API key 발급만으로 격리가 된다고 가정하지 말고 resource-level authorization을 우선 점검해야 한다.
결론
로컬 실행은 배치 방식일 뿐 기밀성 속성이 아니다. prompt가 생성된 순간부터 모든 복사본의 수명, disk retention, tenant별 state owner, shared cache까지 독립적으로 통제해야 end-to-end confidentiality가 성립한다.


댓글