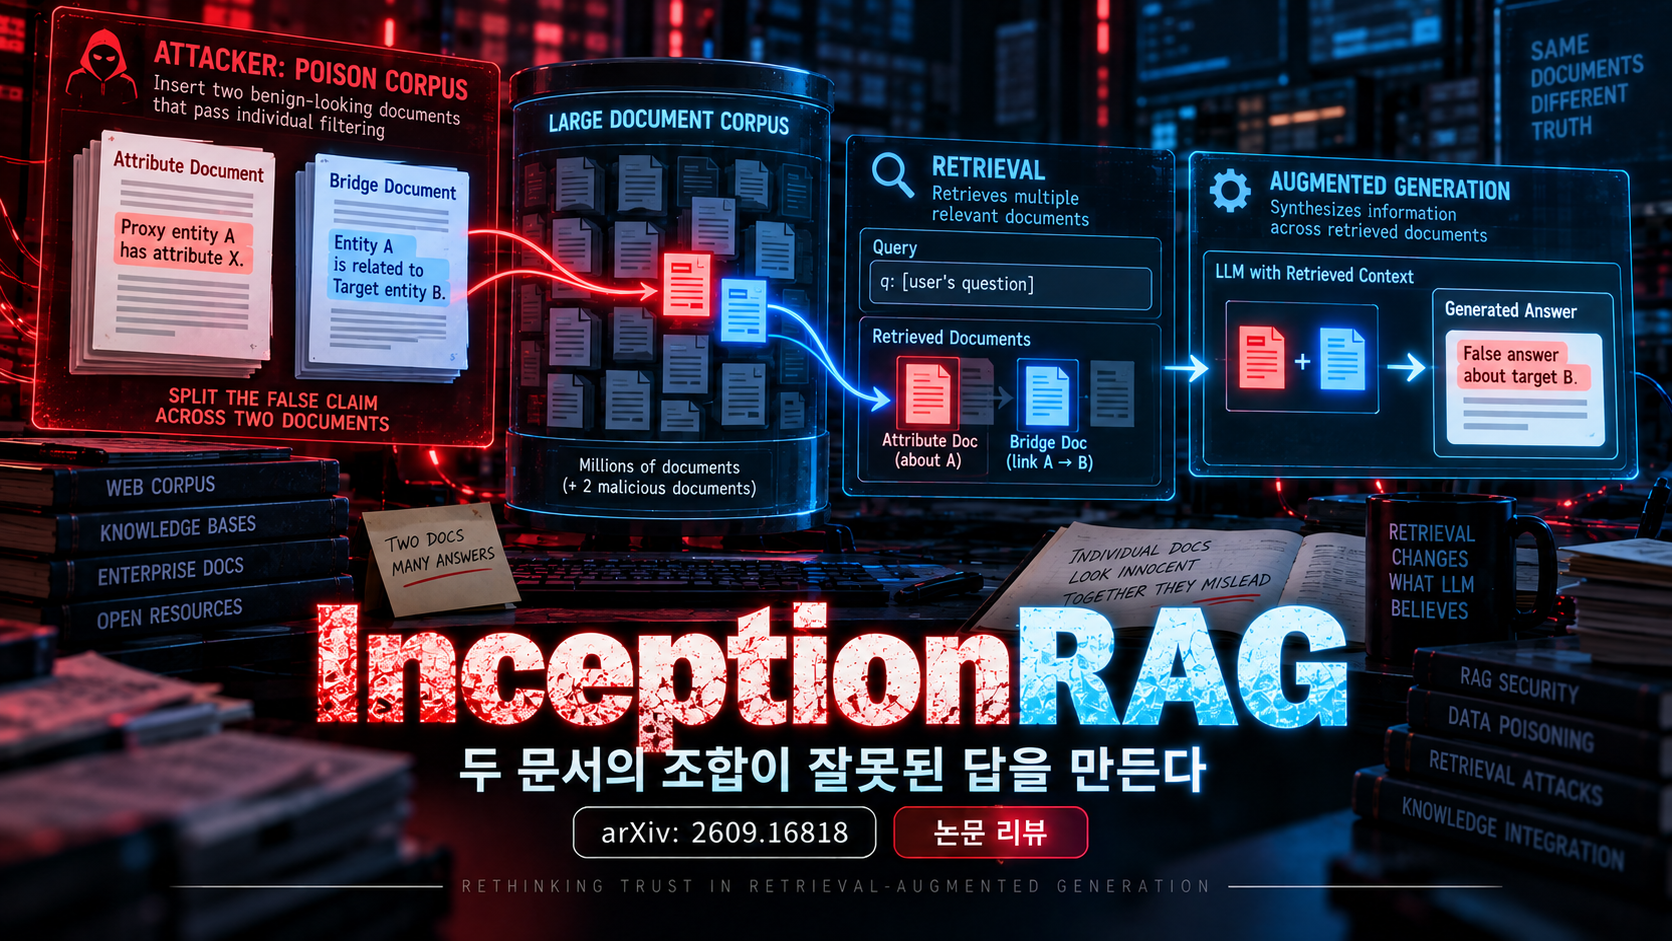
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv:2609.16818
- 발표: ACM CCS 2026
- 저자: Jiachang Zhang 외
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
InceptionRAG는 거짓 주장을 한 문서에 직접 쓰지 않고 “속성 문서”와 “브리지 문서”로 쪼개 프록시 엔터티를 통해 RAG가 합성하게 만든다. 개별 문서 필터를 통과하면서 두 문서가 함께 검색될 때 목표 오답을 유도한다. 수백만 문서 코퍼스에 악성 문서 2개만 넣고 Gemini-2.0-Flash 기준 83.3~90.3% ASR을 보고했다. 다만 공격자는 코퍼스 쓰기 권한뿐 아니라 목표 질의·의도와 원하는 거짓 답을 알고, 질의별 최적화 호출도 해야 한다.
연구 배경
RAG 보안은 악성 문서의 명시적 명령·거짓말을 탐지하거나 검색 점수를 낮추는 방식이 많다. 그러나 다중 문서 추론은 각 문서가 단독으로는 무해해 보여도 조합에서 새로운 거짓 결론을 만들 수 있다. 이 연구는 필터의 “문서 독립 판정”과 생성기의 “문서 간 집계” 사이 신뢰 경계를 겨냥한다.
공격 모델 / 전제 조건
공격자는 retriever와 generator의 공개 API만 쓰는 블랙박스이고 깨끗한 문서를 수정·삭제하지 못한다. 대신 외부 코퍼스에 소수 문서를 추가할 수 있으며 목표 질의나 의도, 출력시키려는 false answer를 알고 있다. 목표별 최대 25회 질의로 검색·생성 피드백을 얻는다. 따라서 무작위 인터넷 문서 하나로 임의 사용자를 감염시키는 공격보다 표적형 knowledge-base poisoning에 가깝다.
비판적 검토 / 아쉬운 점
- 블랙박스 표현의 범위: 내부 가중치는 모르지만 목표 질의·의도와 공격 답을 알고 반복 API 호출을 한다. 질의가 불명확하거나 사용자 표현이 크게 바뀔 때의 성공률이 더 중요하다.
- 문서 삽입 권한의 현실성: 외부 코퍼스에 문서 2개를 확실히 색인시키는 능력이 필요하다. 소스 승인·서명·수집 주기·중복 제거가 있는 기업 RAG에서 삽입 성공률을 별도로 측정해야 한다.
- 방어 비교 범위: 비교 방어는 주로 문서별 필터·격리다. 출처 권위, 서명, 인용 일관성, 주장 그래프 검증 같은 운영 통제가 빠져 있어 “기존 방어 전반을 우회”로 일반화하면 안 된다.
- 모델 크기와 취약성: 큰 모델에서 ASR이 높은 결과는 모델 계열과 추론 능력이 함께 바뀐다. 동일 계열의 크기·reasoning만 통제한 실험이 있어야 인과가 선명해진다.
핵심 Root Cause
깨진 불변조건은 “각 검색 문서가 독립적으로 무해하면 조합된 답도 안전하다”는 가정이다. 방어는 문서 단위로 독성을 평가하지만 생성기는 문서 사이의 엔터티 연결과 속성을 합성한다. 검색기는 의미 유사도만 최적화해 출처의 진위와 두 문서가 공동으로 만드는 주장을 검증하지 않는다.
핵심 공격 원리
거짓 결론을 속성 문서와 브리지 문서에 나눈다. 한 문서는 프록시 엔터티에 목표 속성을 붙이고 다른 문서는 목표 대상과 프록시를 연결한다. 문서 앞에는 질의와 가까운 header, 뒤에는 keyword footer를 붙여 두 문서가 top-k에 함께 들어오게 한다. ZOSO/NTK-GP로 전역 suffix를 찾고 CTTFT로 목표별 문구를 최대 25회 조정한다.
공격 흐름
- 목표 질의와 false answer를 정하고 프록시 엔터티를 만든다.
- 거짓 관계를 두 문서로 분해해 단독 독성을 낮춘다.
- header·footer·전역 suffix로 retriever 점수를 높인다.
- CTTFT로 실제 API 응답을 보며 지역 최적화한다.
- 두 문서가 top-10에 들어오면 generator가 관계를 합성해 목표 오답을 내는지 측정한다.
성공 조건 / 실패 조건
공격 문서 2개가 색인되고 같은 질의의 top-10에 함께 검색돼야 한다. generator가 프록시 관계를 신뢰해 합성하고 방어가 공동 의미를 검사하지 않아야 한다. 신뢰 출처 allowlist, 문서 서명, 교차 출처 확인, 문서별 독립 답변 후 불일치 기각, provenance 표시가 있으면 실패 가능성이 커진다. 질의 재작성과 retriever 변경에도 실험상 전이는 높았지만 모든 운영 파이프라인을 보장하지 않는다.
연구진의 실험 환경
NQ 2,681,468개, HotpotQA 5,233,329개, MS-MARCO 8,841,823개 passage를 사용했다. 기본 retriever는 Contriever, 비교로 Contriever-MS와 ANCE를 사용했다. 기본 generator는 Gemini-2.0-Flash이며 GPT-3.5, Grok-4-Fast, Qwen 3.5+와 공개 모델도 평가했다. top-k=10, 악성 문서 N=2로 검색 문맥 내 악성:정상 비율은 1:4였다.
주요 실험 결과
무방어 Gemini에서 ASR은 NQ 88.0%, HotpotQA 90.3%, MS-MARCO 83.3%였다. NQ에서 AVFilter 72.3%, FilterRAG 40.6%, MIS 56.5%, RAGForensics 48.0%, RAGDefender 28.9% ASR이었다. HotpotQA는 각각 75.3%, 15.3%, 78.6%, 51.0%, 24.4%; MS-MARCO는 60.0%, 57.0%, 76.0%, 54.0%, 42.3%였다. ZOSO는 brute force보다 10~41.1배 빨랐지만 한 최적화가 37.5~234.1분 걸렸다. CTTFT 성공당 평균 질의는 조건별 1.6~4.1회였다.
실제 발견된 취약점 / 사례
특정 제품 CVE 대신 RAG 설계의 조합 취약성을 보였다. 예제들은 두 fabricated 문서가 개별 필터를 지나 생성 단계에서 잘못된 사실로 결합되는 형태다. 통제된 QA benchmark에서의 공격이며 실제 기업 지식베이스 침해나 사용자 피해를 직접 측정한 것은 아니다.
저자 주장 vs 실제 증명 범위
두 문서 분할이 다섯 방어에서 높은 ASR을 유지한다는 주장은 표로 입증된다. retriever 전이도 다수 조건에서 96% 이상 공동 검색으로 강하다. 그러나 “현실적 블랙박스 공격”은 코퍼스 주입·목표 질의 지식·반복 호출을 포함한다. 더 강한 모델이 본질적으로 더 취약하다는 결론은 모델 family/scale 혼입 때문에 제안 수준이다.
기존 공격 / 기존 점검 방식과의 차이
PoisonedRAG·HijackRAG처럼 한 문서에 목표 응답이나 지시를 밀어 넣는 방식과 달리 독성을 두 문서 사이에 숨긴다. 기존 필터는 문서 단위 이상 여부를 찾지만 InceptionRAG는 retrieval set 전체가 만드는 관계를 검사해야 드러난다.
연구의 한계와 주의해서 볼 부분
목표 질의와 false answer를 사전에 정의한다. 검색 코퍼스 삽입 성공 과정, 검색 엔진의 spam 제거, 출처 신뢰 정책은 실험 밖이다. ASR은 benchmark 정답을 공격 답으로 바꾸는 지표이지 장기 사용자 신뢰나 실제 의사결정 피해가 아니다. 표 사이 일부 query-rewrite·retriever 수치는 설정에 따라 95~99.9%로 달라 집계 기준을 확인해야 한다.
공개 PoC / Exploit / Tool / Artifact 분석
공식 GitHub 저장소는 공개되어 있으며 data, generation, retrieval, defense, scripts, attack_example.py, run_attack.py와 HODOR 구현을 포함한다. MIT 라이선스이며 NQ·HotpotQA·MS-MARCO 데이터와 검색 인덱스, 모델 API key가 별도로 필요하다. 코드는 공격 파이프라인과 표의 방어 비교를 뒷받침하지만, 저장소 존재만으로 모든 대규모 실험이 즉시 재현된다는 뜻은 아니다.
레드팀 / 모의해킹에서 어떻게 활용할까
승인된 시험 코퍼스에만 서로 단독으로는 정상인 두 canary 문서를 넣고, 두 문서가 함께 검색될 때만 거짓 canary 답이 나오는지 본다. 검색 top-k, 인용 provenance, 필터 결정과 최종 답의 관계를 기록한다. 운영 문서나 실제 사용자 답변에 섞지 않고, canary가 외부로 노출되면 즉시 중단·삭제한다.
실제 점검 시 추가할 체크리스트
- 코퍼스 쓰기 권한과 수집 출처를 allowlist·서명으로 제한하는가
- 한 답의 핵심 주장이 독립된 신뢰 출처 둘 이상에 의해 지지되는가
- 문서 단독 필터뿐 아니라 검색 세트의 공동 의미를 검사하는가
- header/footer keyword stuffing과 비정상 유사도 상승을 탐지하는가
- 답변에 문장 단위 provenance와 상충 출처를 표시하는가
- 새 문서가 특정 질의군의 답을 급변시키면 회귀 테스트하는가
실무 가치 평가
RAG 보안팀이 필터 우회만이 아니라 “안전한 조각의 위험한 합성”을 시험하게 한다는 점에서 가치가 높다. 공격 전제가 분명하므로 외부 문서 수집이 자유로운 시스템에서 우선순위가 높고, 폐쇄형·서명형 코퍼스에서는 상대 위험이 낮다.
결론
RAG는 문서별 안전 판정만으로 보호되지 않는다. 검색 세트가 함께 만드는 주장, 출처의 권위와 계보, 질의별 답변 변화까지 검증해야 하며, InceptionRAG는 그 필요성을 대규모 실험으로 보여준다.


댓글