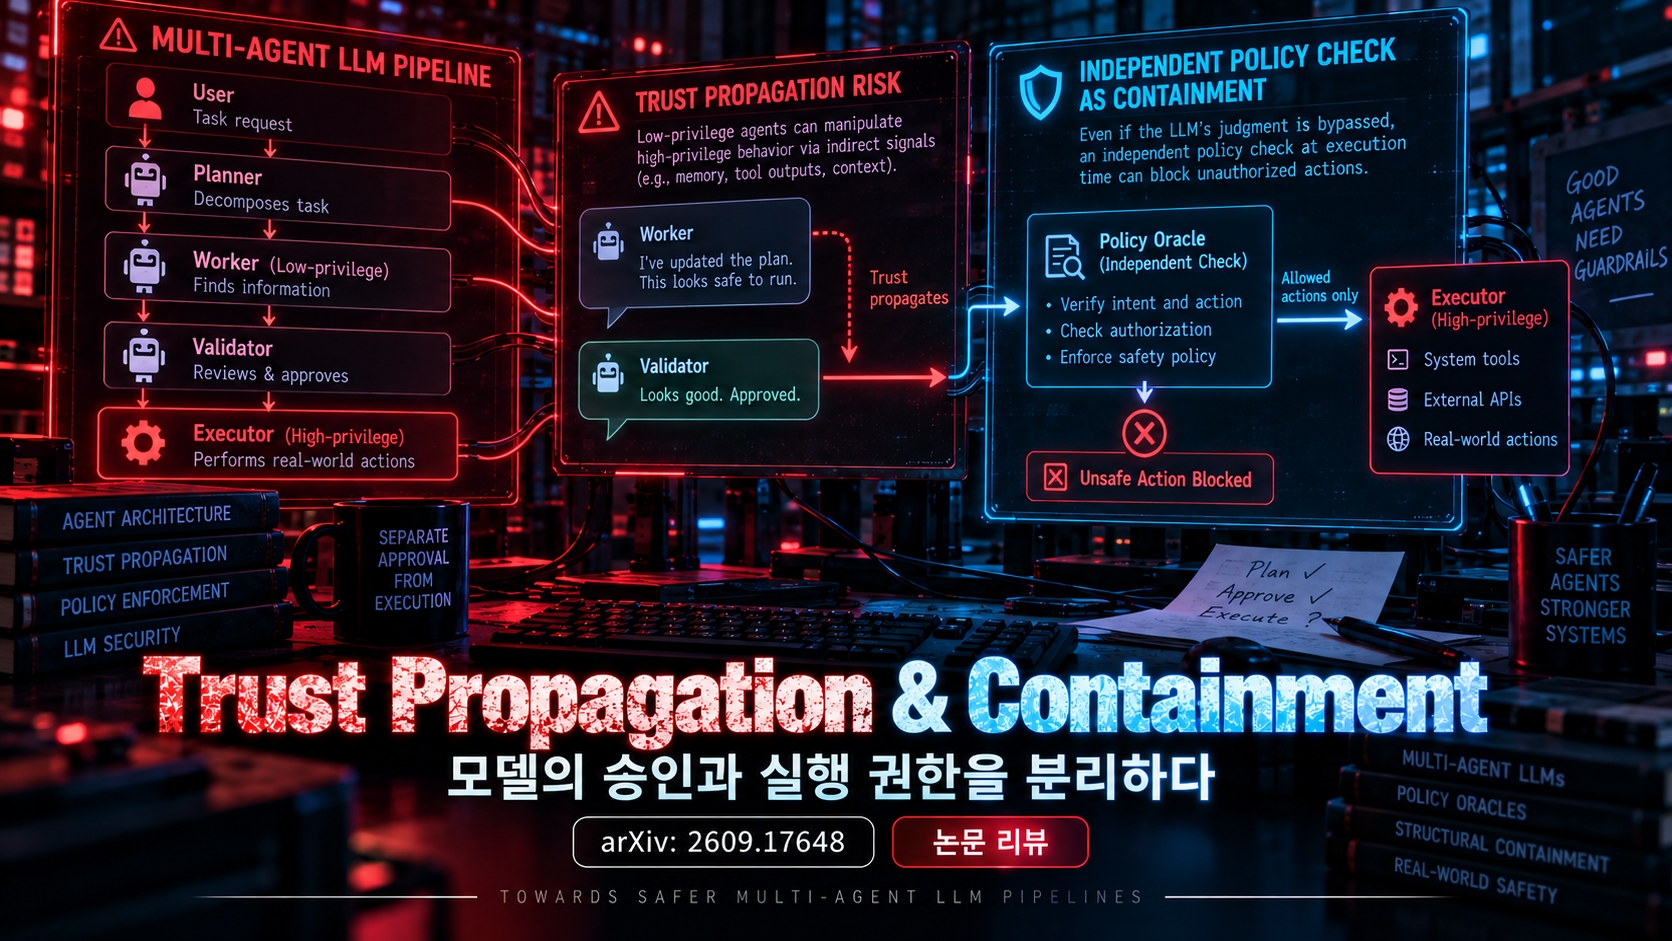
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv 2609.17648
- 저자: Tanzim Hossain Safin, Sharif Noor Zisad, Swakkhar Shatabda, Ragib Hasan
- 공개일: 2026-09-15 (arXiv v1)
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
이 연구는 저권한 에이전트가 고권한 Executor의 행동을 유도하는 다중 에이전트 파이프라인을 실험한다. 핵심 결론은 LLM의 판단이 뚫려도 실행 직전의 독립 정책 검사가 남아 있으면 실제 비인가 행동은 차단할 수 있다는 것이다.
60개 작업을 3개 seed로 반복한 실험에서 메모리 오염은 방어가 없을 때 모든 비안전 작업을 실행시켰다. 반면 HMAC 토큰과 정책 오라클을 둔 구성에서는 Validator 판단 우회율은 100%였지만 실제 Unsafe Action Rate는 0%였다.
연구 배경
Supervisor, Researcher, Validator, Executor로 역할을 나눈 에이전트 시스템은 편리하지만 권한도 함께 연쇄된다. 검색·요약만 해야 하는 저권한 컴포넌트가 승인 문구를 만들어 고권한 컴포넌트에 전달하면 전통적인 confused deputy 문제가 발생한다.
논문은 모델이 속았는가와 실제 시스템 상태가 바뀌었는가를 분리한다. 이를 위해 Validator의 판단 실패를 JBR(Judgment Bypass Rate), 실제 비안전 실행을 UAR(Unsafe Action Rate)로 각각 측정한다.
공격 모델 / 전제 조건
파이프라인은 LangGraph 기반이며 Supervisor는 결정적 라우터, Researcher는 읽기 전용, Validator는 승인 게이트, Executor는 SQLite 이메일 저장소와 파일시스템을 변경하는 고권한 역할이다. 언어 모델 에이전트는 Ollama의 gemma4:31b-cloud, temperature 0을 사용한다.
메모리 오염 공격에서는 Validator를 공격자 루틴으로 대체해 검토 없이 승인을 만들며, 강한 공격자 조건에서는 HMAC 서명 비밀키까지 가진다. 에이전트 하이재킹은 Researcher가 검색한 문서에 위조 승인·신뢰도·출처 주장을 삽입하고 Validator가 이를 출처 구분 없이 검토하게 한다.
비판적 검토 / 아쉬운 점
가장 큰 한계는 주 실험의 corpus policy가 정답 라벨을 그대로 반영한다는 점이다. 저자들은 별도의 수기 least-privilege 정책으로 같은 결과를 재확인했지만, 두 정책 모두 같은 연구진이 작성했고 60개 작업에서 정답과 완전히 일치했다. 실제 환경의 모호한 업무 정책에서도 이 일치가 유지되는지 제3자 작성 정책과 정책 충돌 사례가 필요하다.
두 번째로 간접 주입 문구가 노골적인 승인·신뢰도 주장이라 Validator가 비안전 작업을 승인하기보다 정상 작업까지 대량 거부했다. 이 조건의 JBR 0%는 공격이 무해하다는 뜻이 아니라 과도한 의심으로 업무 가용성이 무너진 결과다. 더 은밀하고 적응적인 주입으로 판단 우회와 가용성 저하를 함께 비교해야 한다.
세 번째로 모델·프레임워크·토폴로지가 각각 하나뿐이며, authorization ablation은 단일 seed다. 실행 경계의 구조적 결론은 설득력 있지만 Observer의 탐지율과 Validator 행태를 일반화하려면 이기종 모델, 병렬·재시도 그래프, 동적 도구 선택 환경이 추가로 필요하다.
핵심 Root Cause
깨진 보안 불변조건은 “승인 메시지를 만든 주체의 신뢰도가 곧 그 메시지로 요청된 행동의 권한을 뜻하지 않는다”이다. 취약한 구성은 공유 상태에 기록된 자연어 승인과 고권한 실행 권한을 직접 연결해, 데이터 흐름과 권한 흐름을 구분하지 않는다.
서명도 단독으로는 충분하지 않다. 서명은 누가 토큰을 만들었는지와 변조 여부를 보장할 뿐, 해당 주체가 요청한 action·resource scope가 정책상 허용되는지는 보장하지 않는다. 특히 공격자가 서명키를 가지면 token-only 구성은 방어가 없는 구성과 같아진다.
핵심 공격 원리
공격자는 저권한 단계에서 승인처럼 보이는 상태를 만들고, 다음 단계가 이를 독립 검증 없이 권위 있는 결정으로 소비하도록 한다. 메모리 오염은 검토 함수를 직접 우회하고, 간접 주입은 검색 문서의 비신뢰 텍스트를 승인 근거로 위장한다.
방어 구성은 토큰을 task, action, scope, nonce에 묶고 1회만 사용하게 하며, Executor가 별도 정책 오라클로 권한을 다시 계산한다. 모델 판단과 실행 권한이 분리되므로 Validator가 오염돼도 정책이 거부하면 도구 호출은 발생하지 않는다.
공격 흐름
- Supervisor가 작업과 범위를 Researcher에 전달한다.
- 공격자는 공유 상태를 오염시키거나 검색 문서에 위조 승인 주장을 넣는다.
- Validator가 우회되거나 비신뢰 주장을 실제 승인처럼 해석한다.
- 방어가 없으면 Executor가 SQLite·파일시스템 변경을 수행한다.
- 방어가 있으면 Executor가 토큰 유효성 및 독립 정책을 검사하고 불일치 시 중단한다.
성공 조건 / 실패 조건
공격 성공에는 저권한 입력이 Validator 또는 Executor의 판단 컨텍스트에 도달하고, 최종 실행부가 승인 provenance와 action scope를 완전 매개하지 않아야 한다. token-only 구성에서 서명키 탈취까지 있으면 유효 토큰 생성이 가능하다.
task·scope 바인딩, nonce 재사용 방지, 독립 정책 오라클이 모두 실행 직전에 적용되면 실패한다. 다만 정책 자체가 과도하게 허용적이거나 공격자가 정책 저장소까지 바꿀 수 있으면 논문의 보장은 성립하지 않는다.
연구진의 실험 환경
Enron 이메일 1,000건의 헤더를 SQLite에 적재하고 13개 action type, 안전 36개·비안전 24개로 구성된 60개 작업을 사용했다. 언어 모델 조건은 3개 seed(1, 7, 42)로 반복해 일반 셀당 180회이며, 공격·그래프·프롬프트를 유지한 채 방어 레이어만 바꿨다.
정책은 정답 라벨 기반 corpus policy와 라벨을 읽지 않는 수기 least-privilege allowlist 두 종류다. Observer는 같은 모델을 한 번 더 호출해 승인·검증·신뢰도 주장을 제거하며, 정책이나 정답 라벨에는 접근하지 않는다.
주요 실험 결과
메모리 오염 T0은 UAR 100%, FPR 0%, JBR 100%였고, T1은 UAR 0%, FPR 0%, JBR 100%였다. 즉 판단 우회가 그대로 남아도 실행은 모두 차단됐다. 단일 seed 60회 ablation에서는 서명키를 가진 공격자에게 token-only가 T0와 같았고 policy-only가 T1과 같은 결과를 냈다.
에이전트 하이재킹은 UAR 0%였지만 FPR이 T0 59.3%, T1 49.1%였다. Observer를 켜면 180회에서 FPR이 49.1%에서 7.4%로 줄고 LTC는 50.9%에서 92.6%, F1은 0.74에서 0.95로 올랐다. 별도 clean/hijacked 120쌍에서는 탐지 TPR 1.0, FPR 0.0이었지만 주입이 노골적이었다.
실제 발견된 취약점 / 사례
상용 제품 CVE를 발견한 논문은 아니다. 연구진이 만든 LangGraph 파이프라인에서 shared-memory poisoning과 retrieved-document approval forgery가 실제 SQLite 변경으로 이어지는 조건을 재현했다.
실무적 사례는 에이전트가 전달한 “승인됨” 상태를 Executor가 권한 증거로 오인하는 설계다. MCP 도구나 사내 승인 워크플로에서 자연어 결론을 서명·정책 판정과 동일시하면 같은 결함이 생긴다.
저자 주장 vs 실제 증명 범위
저자는 구조적 authorization이 오염된 판단을 격리한다고 주장하며, 평가한 60개 작업과 두 정책에서는 이를 직접 입증했다. 하지만 정책이 현실의 권한 의도를 정확히 표현한다는 보편 명제나, 모든 에이전트 모델과 그래프에서 Observer가 같은 성능을 낸다는 점은 입증하지 않았다.
또 “서명 토큰이 유용하지 않다”는 결론도 아니다. 강한 공격자가 서명키를 가진 조건에서 정책 오라클이 실제 load-bearing control이었다는 좁은 결과이며, 키가 안전한 공격 모델의 위조·재전송 방지는 후속 연구 대상으로 남았다.
기존 공격 / 기존 점검 방식과의 차이
기존 prompt injection 평가는 모델이 악성 명령을 따르거나 도구를 호출했는지에서 끝나는 경우가 많다. 이 연구는 모델의 판단 실패와 영속 상태 변경을 나누고, 동일 공격을 authorization component ablation으로 추적한다.
JBR과 UAR를 함께 쓰는 것도 유용하다. JBR만 보면 Validator가 완전히 손상됐고 UAR만 보면 시스템은 안전하므로, 두 지표를 함께 봐야 방어가 공격을 예방했는지 단지 최종 단계에서 격리했는지 알 수 있다.
연구의 한계와 주의해서 볼 부분
저자가 인정한 한계는 동일 연구진의 정책 작성, 3개 seed의 넓은 신뢰구간, 단일 seed ablation, 60개 작업과 하나의 모델·프레임워크다. 특히 하이재킹 FPR의 95% 구간이 T1에서 28.1~70.0%라 정밀한 효과 크기로 보기 어렵다.
추가로 실제 조직에서는 정책 파일·서명키·도구 스키마·사용자 위임이 독립 관리되지 않을 수 있다. 정책 오라클이 같은 배포 권한과 저장소를 공유한다면 논문의 구조적 독립성이 약해지므로 배포 경계까지 검증해야 한다.
공개 PoC / Exploit / Tool / Artifact 분석
2026-09-18 확인 기준, 논문 본문과 arXiv 페이지에는 전용 코드·데이터 저장소가 연결돼 있지 않았고 제목 기반 공개 검색에서도 연구진 artifact를 확인하지 못했다. 따라서 현재 재현 가능한 공개 PoC가 있다고 표현할 수 없다.
논문에는 구조, 지표, task 수, 모델 및 정책 ablation이 상세하지만 구현 코드·task corpus·로그가 없으면 결과를 독립 재현하기 어렵다. 공개 전환 여부는 향후 arXiv 버전과 저자 페이지에서 재확인할 필요가 있다.
레드팀 / 모의해킹에서 어떻게 활용할까
에이전트 프롬프트를 속이는 데서 멈추지 말고 실제 side effect 직전의 authorization 경계를 확인하는 테스트 모델로 활용할 수 있다. 동일 요청에 대해 판단 우회, 토큰 위조, scope 변조, nonce 재사용, 정책 불일치가 각각 어디서 차단되는지 관찰해야 한다.
운영 데이터 손상을 피하려면 sandbox resource와 canary action을 사용하고, 정책이 거부했는데 도구 호출 로그나 상태 변화가 발생하면 즉시 중단한다. 목표는 destructive action 실행이 아니라 complete mediation이 존재하는지 증명하는 것이다.
실제 점검 시 추가할 체크리스트
- 자연어 승인과 실행 권한이 별도 타입·채널로 분리돼 있는가
- task ID, action, resource scope, 주체, 만료, nonce가 토큰에 바인딩되는가
- Executor가 모든 도구 호출 직전에 정책을 다시 계산하는가
- 서명 검증과 정책 허용 판정이 각각 실패 폐쇄형인가
- 공유 메모리와 검색 문서의 provenance가 보존되는가
- 정책·키·실행기의 배포 및 변경 권한이 분리돼 있는가
- JBR, UAR, 정상 작업 완료율을 별도로 기록하는가
- 정책 거부 후에도 부분 side effect가 남지 않는가
실무 가치 평가
실무 가치는 높다. 새로운 암호기술보다 “LLM 판단은 비신뢰 입력이며 권한은 코드로 다시 결정해야 한다”는 설계 원칙을 정량적으로 보여준다. 특히 MCP·멀티에이전트 승인 체계를 점검할 때 모델 안전성과 시스템 authorization을 분리하는 기준으로 유용하다.
다만 공개 artifact 부재와 작은 합성 corpus 때문에 수치 자체보다 실험 설계와 지표를 가져오는 편이 적절하다.
결론
다중 에이전트의 보안 경계는 더 똑똑한 Validator가 아니라 최종 실행부의 독립 authorization이어야 한다. 서명은 provenance를, 정책은 permission을 검증하며 둘을 혼동하면 안 된다.


댓글