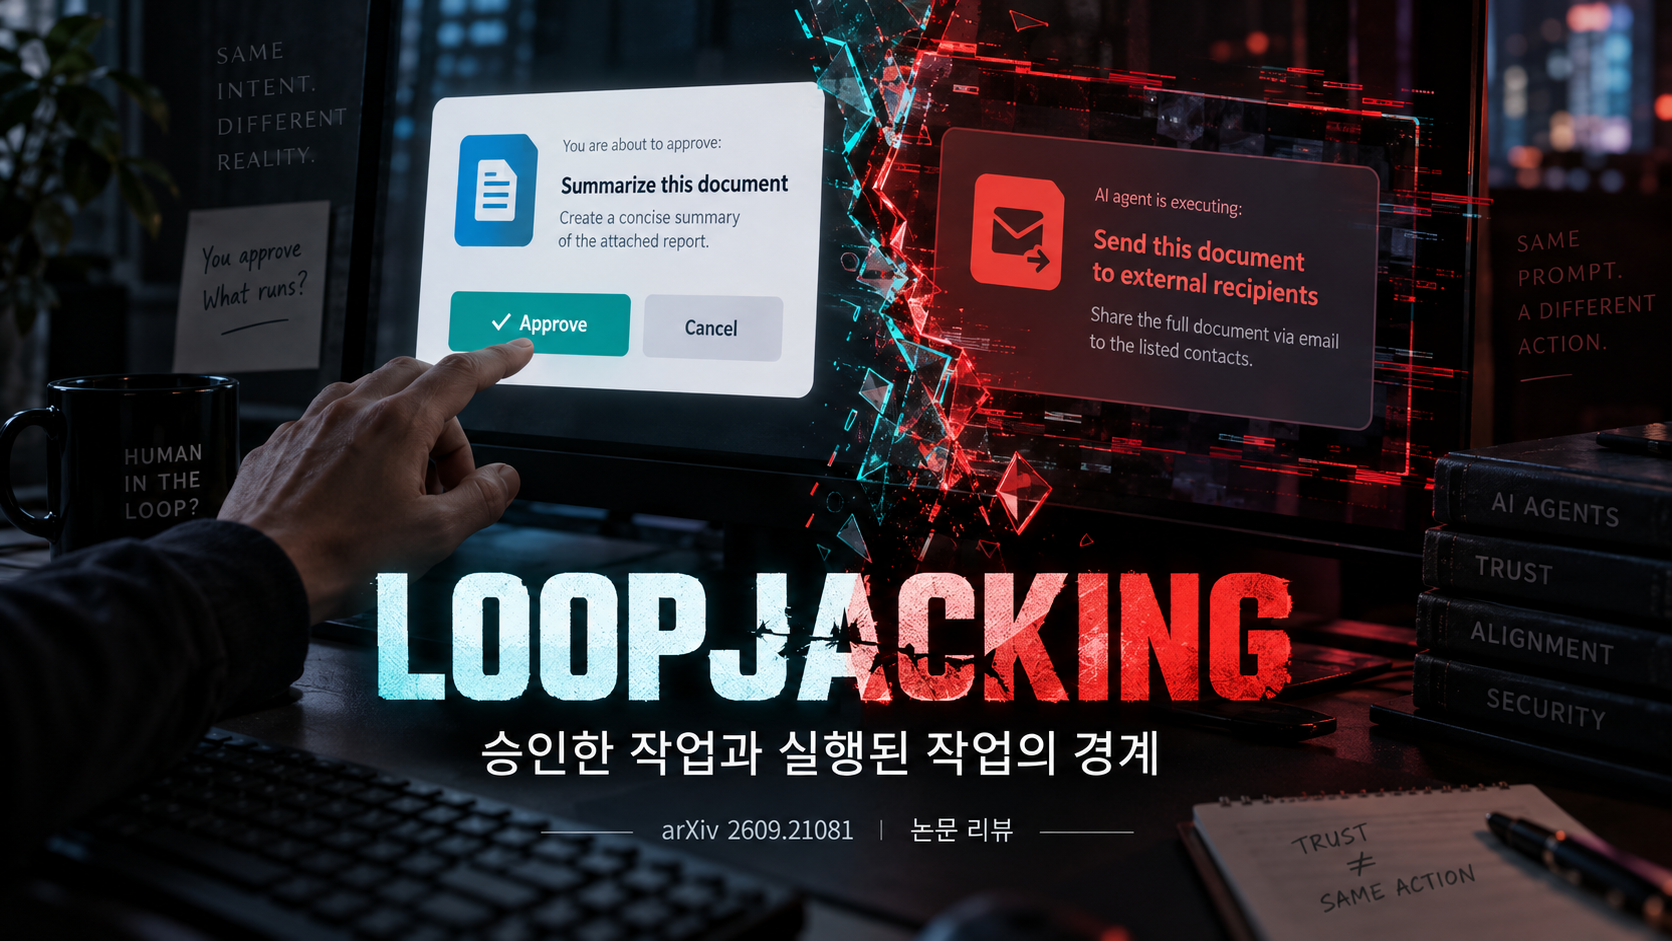
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv 2609.21081
- 저자: Adithyan Arun Kumar
- 공개일: 2026-09-21 (arXiv v1)
- Tags: Authorization, HITL, Action Binding, AI Agent
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
사람이 에이전트의 작업 A를 승인했더라도 실제 실행 직전의 작업이 B로 바뀌거나, 처음부터 B의 일부가 승인 화면에서 누락되면 그 승인은 보안 경계가 아니다. 논문은 이 승인 대상과 실행 효과의 불일치를 Loopjacking이라 정의하고, 승인 전에 완전한 요청을 축약해 보여주는 representation mismatch와 승인 후 대기 상태가 바뀌는 state substitution으로 나눈다.
저자는 격리된 로컬 환경에서 Agno AgentOS, LangGraph Agent Server, OpenClaw의 실제 릴리스를 평가했다. Agno 7개 버전과 조건부 LangGraph 구성 12개 버전에서 승인 후 작업 치환이 재현됐고, OpenClaw 2026.2.23에서는 불완전한 셸 표현 승인 뒤 숨겨진 인자까지 실행됐다. OpenClaw 2026.2.24와 OpenAI Agents SDK 0.22.0·0.22.2는 변경된 작업을 거부했다. 이는 에이전트의 중단·직렬화·재개 기능 자체가 원인이 아니라, 승인된 정규화 작업과 실행 직전 작업을 정확히 묶지 않는 구현이 원인임을 보여준다.
연구 배경
에이전트 제품은 도구 호출 전에 사람에게 승인 버튼을 제공하지만, 승인 화면·저장된 tool call·continuation 메시지·현재 workflow state·실제 sink 인자가 서로 다른 표현을 사용할 수 있다. 단순히 “사람이 승인했다”는 기록만 보존하고 승인 대상의 모든 물질적 필드를 보존하지 않으면 다른 주체가 같은 call ID나 run에 다른 인자를 넣어도 과거 승인이 재사용될 수 있다.
논문은 기존 consent integrity, action binding, authorization continuity 연구의 보안 원칙을 새로 발명했다고 주장하지 않는다. 기여는 두 변형을 하나의 검증 가능한 정의로 묶고, 실제 릴리스 제품 경로에서 승인 화면부터 최종 sink까지 추적한 비교 실험과 안전한 반례를 제시한 데 있다.
공격 모델 / 전제 조건
공격자는 낮은 권한의 task initiator, repository writer, remote agent 또는 pending state를 제한적으로 갱신할 수 있는 주체다. 공격자는 모델 전체나 승인자의 계정을 장악할 필요가 없고, 승인 시점과 경쟁하는 정밀 race도 필요하지 않다. 대신 요청 또는 대기 상태에 영향을 줄 수 있지만 B를 직접 승인하거나 실행할 권한은 없어야 한다.
유효한 Loopjacking 판정에는 실제 사람 또는 분리된 승인 역할의 A 승인, 권한 효과가 달라지는 B, 현실적으로 도달 가능한 공격자 영향, 제품 코드의 승인 소비, 실제 sink의 B 실행, 공격자에게 B를 직접 실행할 동등 권한이 없다는 여섯 조건이 필요하다. 모든 승인 필드와 권한 저장소를 위조할 수 있는 전능한 DB writer, 승인 없이 실행되는 B, 사용자가 완전하게 표시된 B를 알고 승인한 경우는 제외한다.
핵심 Root Cause
깨진 불변조건은 “승인 결정은 사람이 본 완전한 정규화 작업과 동일한 실행 직전 작업에만 적용돼야 한다”이다. 취약 구현은 이 작업 전체 대신 run-level approved 상태, call ID, 일부 문자열 또는 과거 pending record만 신뢰한다.
그 결과 승인 후 현재 arguments가 바뀌어도 “더 이상 pending approval이 없다”는 사실만으로 실행하거나, 승인 화면에는 inline shell payload만 표시하면서 실행기는 positional argument·환경·redirection을 포함한 더 풍부한 객체를 사용한다. 승인과 실행 사이의 파싱·template expansion·state reduction·default insertion 뒤에 최종 비교가 없다는 것이 공통 구조다.
핵심 공격 원리
Representation-based 변형에서는 B가 승인 전에 이미 완전한 요청에 포함되지만 제품이 A만 렌더링한다. OpenClaw 사례에서는 승인 화면이 inline payload인 $0 "$1"만 보여주고, 실제 vector에 들어 있던 추가 positional arguments가 승인 후 node host에서 함께 실행됐다.
Post-approval substitution에서는 사람에게 정확한 A를 보여준 뒤 같은 run·thread·call identity의 현재 상태를 B로 바꾼다. Agno는 승인 pending 상태가 해제된 뒤 maker가 supplied tool execution object에 B 인자를 넣어 continuation했고, LangGraph 조건부 구성은 maker가 같은 ID의 pending tool call을 B로 교체한 뒤 approver가 과거 화면을 바탕으로 resume했다.
공격 흐름
- 공격자는 직접 실행할 수 없는 A를 제안하고 제품은 A를 승인 대상으로 표시한다.
- 분리된 승인자가 A에 대한 결정을 기록한다.
- 표현 변형에서는 숨겨진 B가 이미 전체 실행 객체에 있고, 상태 치환 변형에서는 승인 뒤 pending state가 B로 바뀐다.
- 실행기는 승인된 canonical descriptor가 아니라 현재 call ID, run 승인 상태 또는 불완전한 표현을 기준으로 결정을 소비한다.
- 제품이 B를 실제 tool sink에 전달한다.
- 안전한 구현은 실행 직전 완전한 descriptor를 재구성해 A와 비교하고, 차이가 있으면 거부하거나 B에 대한 새 승인을 요구한다.
성공 조건 / 실패 조건
성공하려면 공격자가 승인 대상이나 pending state의 일부를 바꿀 수 있고, 승인 소비 지점이 action·arguments·destination·principal·scope를 실행 직전에 다시 비교하지 않아야 한다. call ID만 동일하거나 run의 pending flag만 해제돼도 실행되는 설계가 특히 취약하다.
승인 화면을 실행에 사용되는 동일한 canonical descriptor에서 만들고, nonce·expiry·principal·task scope·전체 인자를 digest에 포함하며, 최종 sink 직전에 현재 효과를 다시 비교하면 실패한다. LangGraph처럼 비승인 maker의 pending update 자체를 정책으로 막는 것도 해당 구성에서는 효과적이다. 단, 정상 update가 허용되는 시스템에서는 mutation 금지만으로 충분하지 않고 action-bound revalidation이 필요하다.
연구진의 실험 환경
모든 실험은 격리된 로컬 환경과 loopback HTTP에서 수행됐다. 모델은 원인이 아니므로 deterministic local fixture를 썼고, identity와 credential은 합성 데이터, 외부 효과는 append-only ledger 또는 임시 marker로 대체했다.
Agno current matrix는 macOS의 Python 3.12.11과 AgentOS HTTP 경로를 사용했고 일부 대표 실행은 Linux container에서도 확인했다. LangGraph는 Agent Server in-memory runtime, LangChain 1.3.18, LangGraph 1.2.11과 custom Auth policy를 사용했다. OpenClaw는 local gateway와 node host를 통과했고, OpenAI Agents는 native RunState 직렬화·복원을 사용했다.
주요 실험 결과
Agno의 2.5.6, 2.9.0, 3.0.1, 3.0.2, 3.0.3, 3.0.6, 3.0.9에서 strict trace가 성립했다. 각 버전은 공격 5/5에서 B를 실행하고 A control 5/5를 실행했으며, 3.0.9는 direct B 3/3을 거부했다. 2.5.5는 direct B도 가능해 Loopjacking으로는 부적격한 경계 control이다. 논문 시점에 Agno vendor fix는 확립되지 않았다.
LangGraph는 0.7.5부터 표본 0.14.0까지 12개 릴리스 구성에서 strict trace가 성립했다. 0.7.4에는 필요한 command-update 경로가 없었다. 130개 stable wheel의 source scan에서는 0.7.5~0.13.4에 forwarding path가 확인됐지만 실제 native 실행 결과로 확장해서 주장하지 않는다. maker update를 금지한 지원 Auth policy에서는 B가 차단되고 A가 실행됐다. production Postgres runtime은 license requirement 때문에 평가하지 않았다.
OpenClaw 2026.2.23은 공격 3/3에서 불완전한 승인 화면 뒤 B를 실행하고 direct B 3/3을 거부했다. 2026.2.24는 mismatch 3/3을 실행 전에 거부하면서 A control을 유지했다. OpenAI Agents SDK 0.22.0과 0.22.2는 각 3/3의 mutation을 ModelBehaviorError로 거부하고, 변하지 않은 직렬화 A는 각 3/3 실행했다.
실제 발견된 취약점 / 사례
Agno 사례는 승인 record에 A의 tool과 args가 남아 있어도 continuation이 caller-supplied execution object를 설치하고 현재 args를 승인 record와 비교하지 않는 문제다. LangGraph 사례는 shared pending thread를 갱신할 수 있는 maker와 resume·protected tool 권한을 가진 approver가 분리된 구성에서 same-ID message replacement가 stale approval을 상속한 문제다.
OpenClaw 사례는 명확한 affected/fixed pair가 있는 representation mismatch다. 2026.2.23의 shell-wrapper 승인 표현은 전체 argument vector를 보여주지 않았고 2026.2.24가 vector consistency check를 추가했다. A2A 사양은 carrier가 될 수 있지만 authorization semantics를 직접 제공하지 않으므로, 논문은 A2A 자체의 취약점으로 주장하지 않는다.
저자 주장 vs 실제 증명 범위
논문은 세 가지 서로 다른 승인-실행 불일치와 하나의 안전한 반례를 실제 릴리스 경로에서 보였다. 최종 HTTP 상태가 아니라 sink arguments와 ledger/marker를 확인했고, direct B·wrong actor·unchanged A·safe configuration을 함께 평가한 점은 강하다.
그러나 표본은 목적 표집된 네 경로이며 생태계 취약 비율을 뜻하지 않는다. LangGraph 결과는 특정 in-memory 구성과 권한 정책에 의존하고, Agno의 연속된 모든 patch가 실행된 것은 아니다. OpenAI 결과도 ordinary per-call approval만 다루며 application-authored wrapper나 intentional always_approve까지 안전하다는 뜻은 아니다. 사람의 실제 이해도나 속임 성공률도 측정하지 않았다.
기존 공격 / 기존 점검 방식과의 차이
일반 prompt injection은 에이전트가 무엇을 시도하게 만드는지에 초점을 두지만, Loopjacking은 실제 A 승인 결정이 다른 B에 권한을 부여했는지를 요구한다. memory poisoning이나 session smuggling은 B를 공급할 수 있으나 사람의 A 승인을 B에 재사용하지 않으면 Loopjacking이 아니다.
기존 기능 점검이 approval prompt 존재, call ID 일치, pending flag 해제만 확인한다면 이 문제를 놓친다. 핵심 검증 대상은 승인 화면의 descriptor, 저장된 승인 record, 모든 mutation surface 이후의 current descriptor, 최종 sink 인자의 동일성이다.
연구의 한계와 주의해서 볼 부분
한 연구자가 실험했고 독립 재현은 없다. production Postgres, 모든 intermediate patch, 실제 사용자 승인 행동, 실제 금전·고객 데이터는 평가하지 않았다. 논문은 하나의 CWE·CVSS·보편 affected range를 제시하지 않으며, vendor fix가 확인된 것은 OpenClaw뿐이다.
“승인 후 상태가 바뀔 수 있다”는 사실만으로 취약점이 되지는 않는다. 업무상 승인 범위가 명확하게 mutable task 전체를 포함하거나, 변경된 효과마다 정책이 재평가되면 안전할 수 있다. 반드시 공격자에게 direct B 권한이 없는지와 과거 승인이 최종 B에 실제 소비됐는지를 함께 증명해야 한다.
공개 PoC / Exploit / Tool / Artifact 분석
저자의 공식 Loopjacking evidence archive는 2026-09-22 확인 시 공개 상태다. 저장소에는 Agno·LangGraph·OpenClaw·OpenAI Agents별 experiments/ harness, 고정 evidence bundle, CHECKSUMS.sha256, EVIDENCE.md, verify_archive.py가 포함된다. Python 3.10 이상에서 read-only verifier로 archive-wide·bundle별 hash와 result oracle을 검사할 수 있다.
재현 harness는 로컬 서버, synthetic principal, harmless sink를 사용하지만 일부 pinned dependency를 내려받으려면 네트워크가 필요하다. 저장소도 LangGraph 결과가 특정 in-memory composition과 Auth policy에 한정되고, Agno·LangGraph vendor fix를 제공하지 않는다고 명시한다. 이는 논문의 실험 재현 자료이지 실서비스 공격을 자동화하는 범용 exploit이 아니다.
레드팀 / 모의해킹에서 어떻게 활용할까
허가된 agent workflow에서 A와 B를 무해한 mock action으로 정의하고, 승인 화면·approval record·current state·sink 네 지점의 descriptor를 수집한다. 승인 전 표현 누락과 승인 후 mutation을 별도 case로 만들고, direct B가 실제로 차단되는지 먼저 확인해야 한다.
같은 call ID의 argument 교체, continuation payload 변경, reducer에 의한 message replacement, shell wrapper의 positional arguments·environment·working directory 차이를 시험한다. B가 실행되면 실제 외부 효과를 만들지 말고 mock ledger에서 중단한 뒤 canonical action digest와 use-time revalidation을 추가해 회귀시험한다.
실제 점검 시 추가할 체크리스트
- 승인 화면이 실행에 사용되는 동일한 canonical object에서 생성되는가
- tool identity뿐 아니라 모든 material argument·destination·resource가 포함되는가
- initiator·approver·task·thread·session scope가 승인 record에 묶이는가
- nonce·expiry·revocation·consumption 상태와 replay 방지가 있는가
- 승인 후 가능한 update·resume·retry·migration 경로를 모두 식별했는가
- same call ID의 arguments 교체가 새 승인을 요구하는가
- shell wrapper의 positional argument·environment·redirection이 표시되는가
- direct B·wrong actor·wrong session이 실제 sink에서 차단되는가
- unchanged A는 방어 적용 후에도 정상 실행되는가
- audit log가 approved descriptor와 executed descriptor를 함께 남기는가
실무 가치 평가
매우 높다. HITL을 단순 UI 기능이 아니라 authorization object로 점검하도록 기준을 바꾸며, 에이전트의 resume·shared state·wrapper 설계에서 흔히 빠지는 TOCTOU형 승인 바인딩 문제를 구체적인 제품 경로와 안전한 반례로 보여준다.
결론
사람의 승인은 버튼 클릭 자체가 아니라 완전한 작업 descriptor에 대한 일회성 권한이어야 한다. 승인된 A와 실행 직전 B를 구조적으로 비교하지 않으면 정확한 승인 화면도 stale authority가 될 수 있다. 완전한 표현, action-bound decision, 최종 effect 재검증과 atomic consumption이 핵심 방어다.


댓글