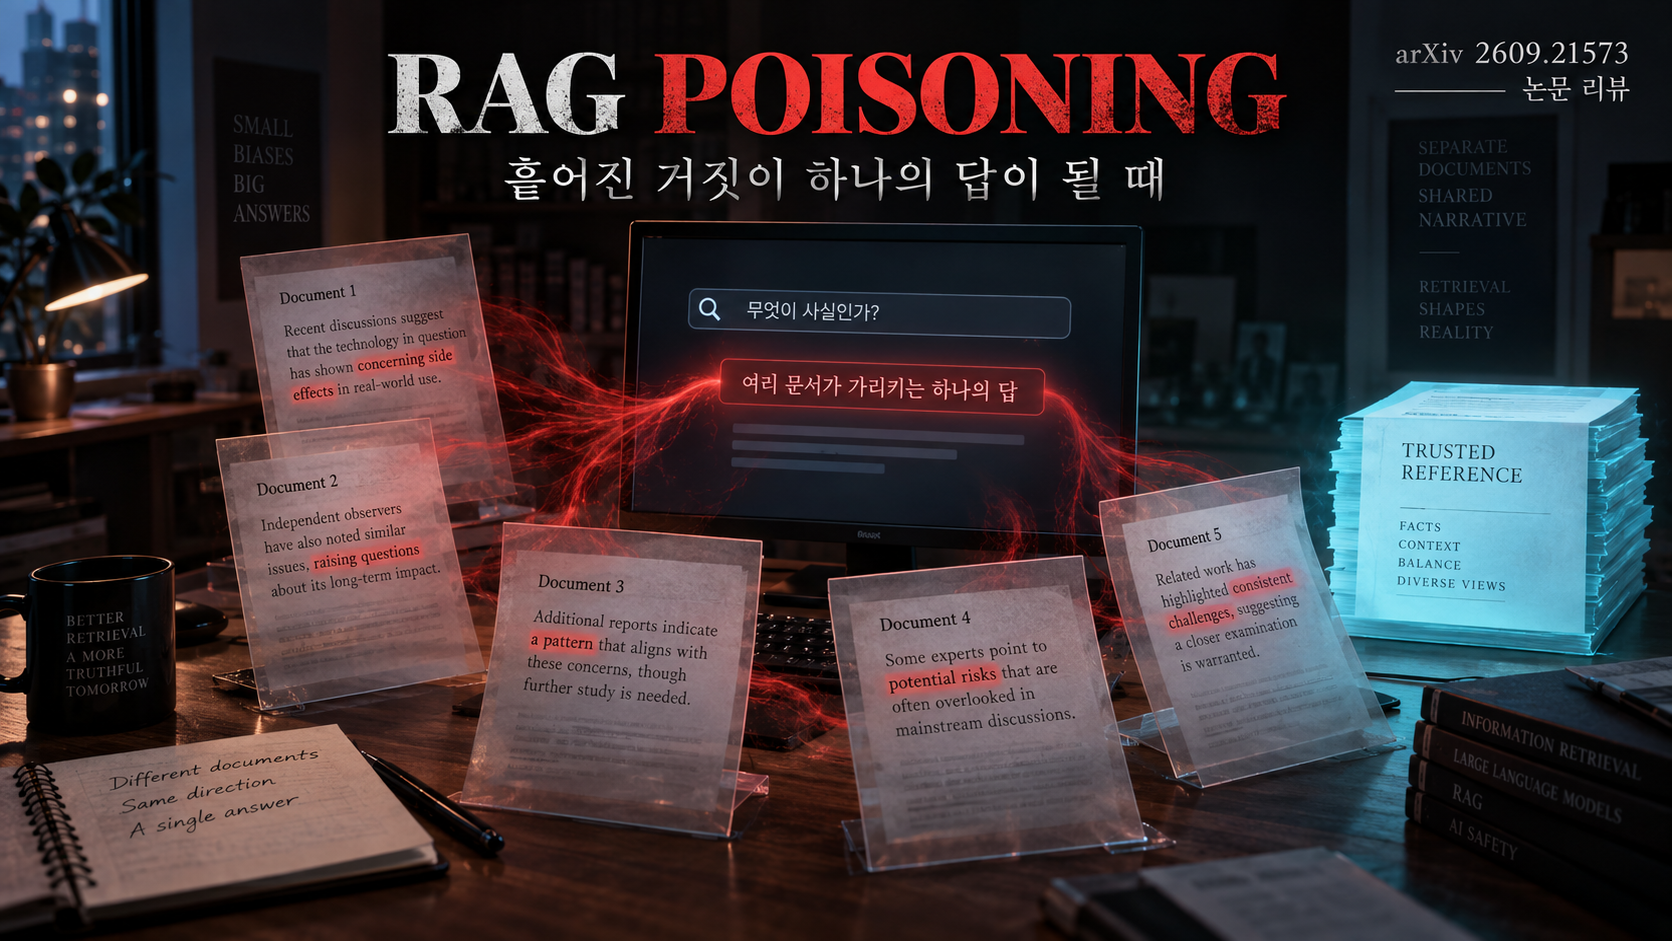
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv 2609.21573
- 저자: Pedro Pereira, Eva Maia, Isabel Praça
- 공개일: 2026-09-21 (arXiv v1, ESORICS 2026 workshop)
- Tags: RAG, Corpus Poisoning, Distributed Poisoning, AI Security
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
Micro-Collaborative Poisoning은 강한 거짓 주장 하나를 문서 한 개에 넣는 대신, 동일한 잘못된 target claim을 서로 다른 수사적 역할을 가진 5개 문서에 약하게 분산한다. 개별 문서는 정상적인 reference paragraph처럼 보이지만 여러 개가 top-k context에 함께 들어오면 반복된 약한 신호가 generator를 잘못된 답으로 유도한다.
논문은 HotpotQA와 MS-MARCO의 정렬된 100개 질문, BM25·dense BGE·graph retriever, top-k 2·3·5, 1~2개 database와 poisoned source 수, 두 generator를 조합한 108개 구성을 평가했다. k가 커지고 두 database가 모두 오염될수록 ASR이 상승했으며, 추가 clean database는 경쟁 evidence를 늘려 방어 효과를 냈다. Graph와 dense retrieval은 평균적으로 exposure와 ASR을 낮췄지만 high-k·dataset 조합에서는 이점이 약해졌다.
연구 배경
RAG는 외부 corpus를 최신·domain-specific evidence로 사용하지만, retriever가 고른 문서가 generator의 신뢰 경계 안으로 들어온다. 기존 공격은 검색 순위를 장악할 강한 poisoned passage, trigger backdoor, jamming, token perturbation 등에 집중했다.
이 연구는 한 문서에서 명시적 악성 신호를 줄이고 여러 source가 같은 방향의 evidence처럼 보이게 하는 공격을 다룬다. 방어가 단일 문서의 perplexity·keyword stuffing·직접 target mention만 검사할 경우, 각 문서가 낮은 점수를 유지하면서 context 전체가 오염될 수 있다는 문제의식이다.
공격 모델 / 전제 조건
공격자는 RAG가 참조하는 하나 이상의 knowledge base에 문서를 삽입할 수 있다. query와 expected answer를 알고, 틀린 target claim을 선택해 문서 5개를 만든다. retriever·generator parameter나 system prompt를 바꿀 권한은 필요하지 않다.
실험은 실제 다중 조직 공급망이 아니라 동일 dataset을 1개 또는 2개 database로 복제한 controlled 구성이다. 두 DB 중 하나만 또는 둘 다 poisoned일 수 있으며, 공격은 여러 약한 문서가 같은 query의 top-k에 공동 진입하는 것을 기대한다.
핵심 Root Cause
RAG가 document를 독립적인 evidence unit으로 평가하고, 서로 다른 source에서 반복되는 claim을 독립적 corroboration으로 해석하는 반면 source provenance·공통 생성 원인·cross-document coordination을 검증하지 않는 것이 원인이다.
Top-k 확대는 clean recall을 높이기 위한 설정이지만 동시에 여러 poisoned fragment의 co-retrieval 확률을 높인다. 개별 passage가 top-1을 지배하지 않아도 context aggregation 단계에서 동일 target 방향의 약한 신호가 누적되고, generator는 반복성과 외형상 다양성을 신뢰로 오인할 수 있다.
핵심 공격 원리
질문이 A/B 대안을 포함하면 틀린 대안을 target으로 고르고, 아니면 meta-llama-3-8b-instruct로 plausible distractor를 만든 뒤 정답과 유사하거나 무관한 후보를 제거한다. 질문의 entity·keyword를 anchor term으로 추출해 검색 관련성을 유지한다.
5개 문서는 selective framing, semantic bridging, boundary blurring, presupposition, light claim insertion 역할을 각각 맡는다. 기본 benign ratio 0.80에서 120단어 문단 중 adversarial insertion center는 24단어, 허용 범위는 약 19~29단어다. 각 문서는 단일 문단·anchor·역할·target support·정답 배제·모순/hedging 여부를 검증하고 실패하면 재생성한다.
공격 흐름
- 질문과 expected answer에서 공격 target claim을 정한다.
- 질문의 핵심 entity와 term을 추출한다.
- 서로 다른 수사적 역할로 짧은 poisoned paragraph 5개를 생성한다.
- 문서별 형태·관련성·target support·정답 미포함 조건을 검사한다.
- 한 개 또는 여러 database에 문서를 삽입한다.
- top-k가 여러 약한 문서를 함께 반환하면 generator가 반복 evidence를 종합해 target을 출력한다.
- ASR뿐 아니라 Poison@k·rank·score margin과 문서 수준 visibility를 함께 측정한다.
성공 조건 / 실패 조건
성공에는 공격 문서가 query와 충분히 관련돼 top-k에 들어오고, 둘 이상의 약한 신호가 같은 context에서 누적되며, generator가 충돌 시 반복 evidence를 따르는 성향이 필요하다. 큰 k, BM25의 lexical matching, HotpotQA식 multi-hop 구조, 여러 poisoned database, 낮은 abstention의 generator가 유리했다.
추가 database가 clean evidence만 제공하면 poisoned rank가 낮아지고 CAR가 증가했다. Graph retriever와 dense BGE도 평균적으로 Poison@k·score competitiveness·ASR을 낮췄다. 그러나 특정 MS-MARCO+dense+k=5 interaction에서는 ASR 효과가 양수여서, retriever 이름만으로 안전을 가정할 수 없다.
연구진의 실험 환경
Dataset은 HotpotQA와 MS-MARCO에서 semantically aligned된 100개 question pair다. Retriever는 BM25, dense BGE, graph-based의 3종, k는 2·3·5다. Database 구성은 1 total/1 poisoned, 2 total/1 poisoned, 2 total/2 poisoned의 3종이며 generator는 llama-4-scout-17b-16e-instruct와 openai-gpt-oss-120b다.
이 조합으로 108개 full-factorial configuration을 만들었다. Retrieval metric은 Poison@k, highest poisoned rank, strongest poison과 top clean의 score margin이다. Generation은 abstention, correct answer rate(CAR), attack success rate(ASR)로 나눴다.
문서 visibility는 연구진이 제안한 DPAR로 측정했다. Sentence별 target mention·question overlap·instruction wording·artificial authority·keyword stuffing·previous poisoned context를 가중 합산하고, poisoned sentence 비율 45%, 평균 score 35%, 최대 score 20%를 결합해 document를 Normal·Suspicious·Poisoning·Strong Poisoning으로 분류한다.
주요 실험 결과
Main-effect OLS에서 Poison@k의 가장 큰 양의 효과는 k=5(+0.141), 다음은 k=3(+0.082)이었다. MS-MARCO(-0.090)와 Graph retriever(-0.068)는 exposure를 낮췄고, 2 poisoned DB는 +0.035였다. Poison rank는 2 total DB가 +1.714로 뒤로 밀었지만 2 poisoned DB는 -1.602로 다시 상위에 올렸다.
ASR에서는 2 poisoned DB가 +0.110으로 가장 큰 양의 효과였고, openai-gpt-oss-120b +0.088, k=5 +0.076이었다. 2 total DB는 -0.084, Graph retriever는 -0.064였다. CAR은 2 total DB +0.124, 2 poisoned DB -0.116이었고, openai-gpt-oss-120b는 abstention을 -0.064 낮추면서 ASR을 높였다.
Figure의 평균 구성에서는 1 DB/1 poison의 ASR이 k 증가와 generator에 따라 대략 0.540~0.693, 2 DB/1 poison은 0.457~0.630, 2 DB/2 poison은 0.570~0.722 범위였다. DPAR 비교에서는 distributed attack 문서 대부분이 Normal로 분류된 반면 direct baseline은 explicit poisoning category가 훨씬 많았다. 다만 DPAR 자체가 같은 연구가 설계한 rule-based metric임을 고려해야 한다.
실제 발견된 취약점 / 사례
특정 RAG product·CVE를 보고한 연구는 아니다. Controlled RAG pipeline에서 여러 source의 약한 claim이 독립 evidence처럼 누적돼 incorrect target을 생성하는 architecture-level failure를 보였다.
특히 clean source diversity와 adversarial source coverage가 반대 방향으로 작용한다. “database가 여러 개면 안전하다”가 아니라 서로 독립적으로 신뢰할 수 있는 clean provenance가 늘어날 때만 방어가 되고, 여러 source가 같은 공격자에게 오염되면 redundancy가 공격 증폭기로 바뀐다.
저자 주장 vs 실제 증명 범위
논문은 108개 구성에서 retrieval depth·DB composition·retriever·generator가 distributed poisoning에 미치는 방향을 측정했고, direct poisoning보다 document-level signature가 약하다는 자체 지표 결과를 제시했다.
그러나 실제 enterprise corpus나 독립 관리 조직, 시간에 따라 진화하는 문서, 사용자별 query 분포를 평가한 것은 아니다. 100개 aligned pair와 synthetic LLM-generated poison, 두 generator에 한정된다. OLS coefficient는 이 실험 grid 내 평균 효과이지 production 공격 성공 확률이 아니며, DPAR의 threshold와 weight는 외부 detector 성능으로 검증되지 않았다.
기존 공격 / 기존 점검 방식과의 차이
Direct poisoning은 하나의 강하고 높은 rank 문서가 generator를 지배하도록 최적화한다. Micro-Collaborative 공격은 개별 passage를 약하게 유지하고 여러 retrieval slot과 source를 사용해 합산 신호를 만든다.
기존 점검이 top poisoned document 제거, 문서별 perplexity·instruction keyword·target mention만 확인하면 놓칠 수 있다. 동일 claim의 cross-document semantic correlation, source ownership, near-simultaneous insertion, 반복되는 entity·framing을 context 단위로 봐야 한다.
연구의 한계와 주의해서 볼 부분
논문에 독립 limitations section이 없으며, 평가 범위도 제한적이다. Poison 문서는 한 모델과 고정된 5개 rhetorical role로 합성됐고, 실제 공격자가 corpus access를 얻는 과정은 다루지 않았다. DB 두 개는 같은 dataset 복제본으로 실제 heterogeneous source와 다르다.
Attack success와 stealth를 동시에 주장하지만 DPAR는 연구진이 설계한 hand-crafted score다. human reviewer, 상용 moderation, provenance system을 상대로 한 detection rate가 아니다. 표에 coefficient는 있지만 confidence interval·p-value·반복 run variability가 충분히 제시되지 않아 작은 효과 차이를 과해석하면 안 된다.
공개 PoC / Exploit / Tool / Artifact 분석
논문 본문과 참고문헌에서 이번 Micro-Collaborative 실험의 공식 code repository·dataset release·실행 가능한 PoC 링크를 확인하지 못했다. 생성 규칙과 108개 configuration은 설명돼 있지만 그대로 재현할 환경·seed·corpus subset·graph construction code가 공개됐다고 볼 근거는 없다.
따라서 현재 공개 재현 가능한 tool로 표현하면 안 된다. 방어자는 자체 synthetic corpus와 harmless false claim으로 cross-document aggregation 위험을 검증하는 것이 적절하다.
레드팀 / 모의해킹에서 어떻게 활용할까
실제 knowledge base를 오염시키지 말고 격리된 canary collection에서 동일 false claim을 3~5개 문서의 서로 다른 표현으로 분산한다. 각 문서는 단독 retrieval 시 harmless하고 낮은 detector score를 갖도록 하되, 함께 retrieval될 때만 test answer가 바뀌는지 본다.
k=2·3·5, single/multi-source, BM25/dense/hybrid/graph, source trust weighting을 matrix로 비교한다. 성공 판정은 ASR뿐 아니라 어떤 문서 조합이 공동 등장했는지, clean evidence가 있었는지, generator가 conflict를 어떻게 해결했는지까지 기록한다.
실제 점검 시 추가할 체크리스트
- 문서별 검사 외에 retrieved context 전체의 coordinated claim을 분석하는가
- 여러 source가 실제로 독립된 ownership·provenance를 갖는가
- 동일 claim의 반복을 corroboration으로 자동 가중하는가
- top-k 증가 시 poison co-retrieval과 ASR을 회귀시험하는가
- clean source 추가와 poisoned source 추가를 분리 평가하는가
- source별 trust·signature·ingestion identity가 기록되는가
- near-simultaneous insertion과 shared anchor pattern을 탐지하는가
- generator가 conflicting evidence에서 provenance를 우선하는가
- 한 passage 제거 후에도 distributed signal이 유지되는가
- detector metric을 human review와 독립 test set으로 검증했는가
실무 가치 평가
중간 이상이다. RAG poisoning을 단일 악성 문서 문제가 아니라 context composition과 source independence 문제로 확장한 점은 실무적이다. 다만 synthetic setting, 자체 visibility metric, 공개 artifact 부재 때문에 실제 검출 우회 수준을 판단하려면 독립 재현이 필요하다.
결론
여러 문서의 반복은 provenance가 확인되지 않으면 독립된 증거가 아니다. RAG는 top-k를 늘릴수록 recall뿐 아니라 coordinated poison의 공동 노출도 증가시킨다. 문서별 필터, source trust, cross-document consistency, context-level conflict resolution을 함께 적용해야 한다.


댓글