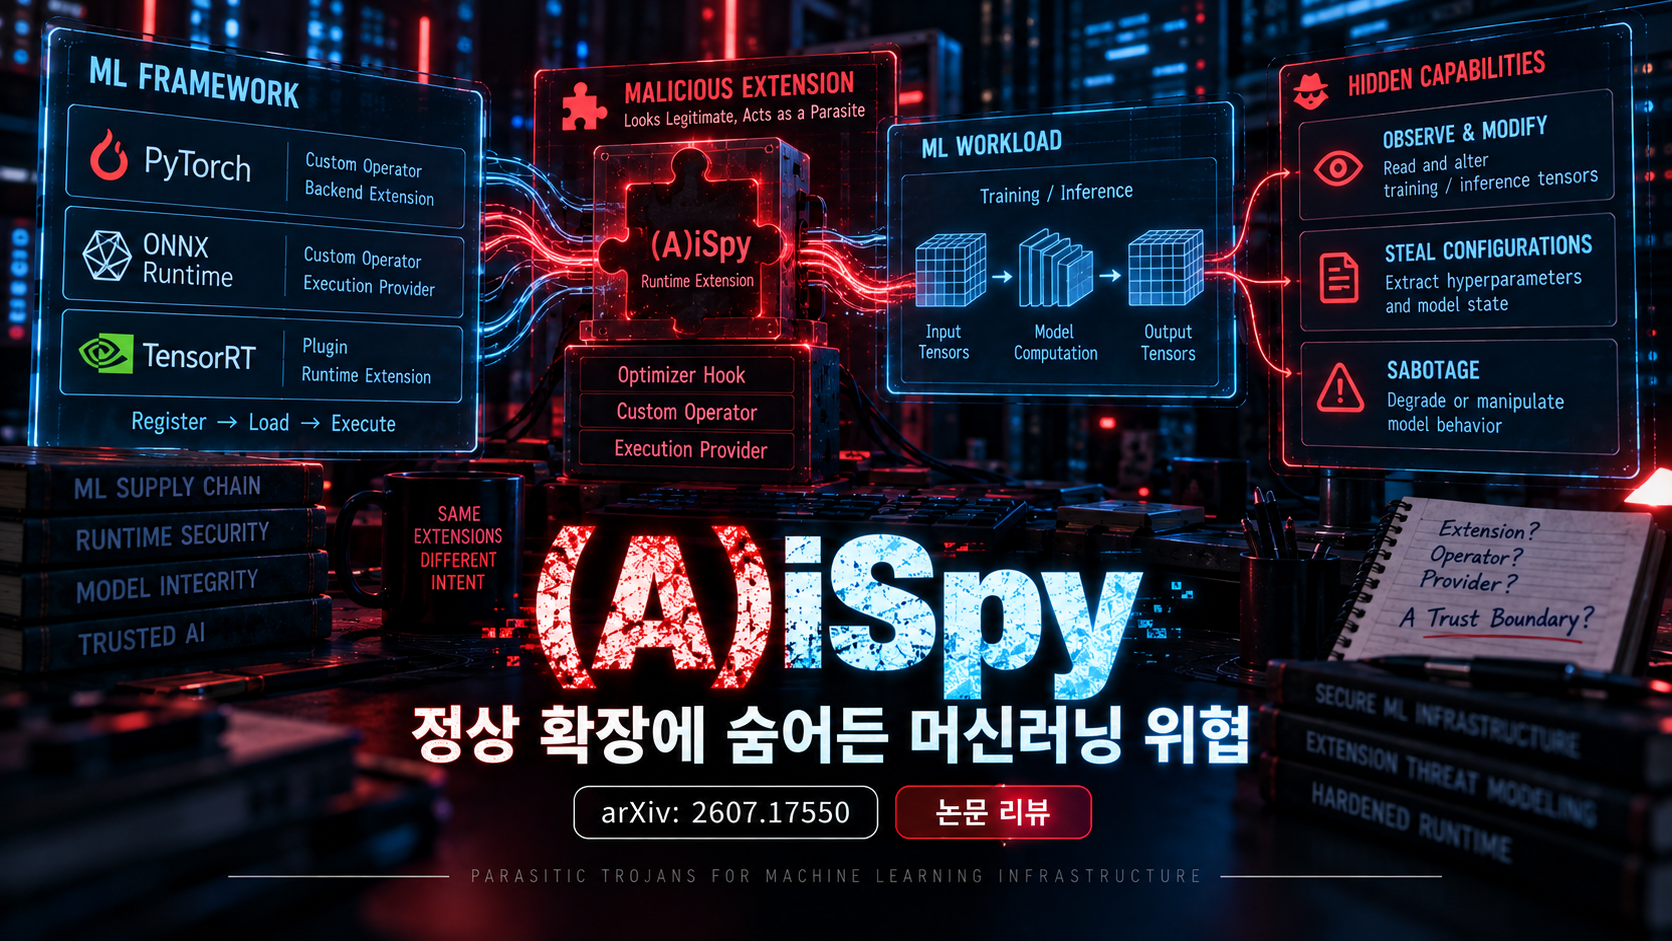
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv:2607.17550
- 저자: Habibur Rahaman 외
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
AiSPY는 ML runtime extension이 optimizer·custom operator·execution provider로 등록되면 학습·추론 tensor를 관찰·변조하고 상태를 유지할 수 있다는 연구다. ONNX Runtime, PyTorch, TensorRT의 확장 지점을 이용해 소량 poison의 backdoor 증폭, hyperparameter 유출, sabotage를 보인다. 가장 중요한 전제는 악성 native/runtime 확장이 이미 설치됐다는 점이다. 논문은 최초 침투보다 “정상 확장처럼 들어온 코드가 egress 없이 ML 상태를 악용하는 방식”을 설명한다.
연구 배경
ML 보안은 모델 파일·데이터·API 출력에 집중하지만 실제 pipeline은 graph optimizer, kernel, execution provider, hook 같은 고권한 확장 코드를 신뢰한다. 이 코드는 OS 권한 상승 없이도 gradient, weight, activation을 만지고 실행 그래프 안에서 계산한다. 일반 EDR이나 네트워크 감시는 정상 ML 연산과 악성 tensor 조작을 구분하기 어렵다.
공격 모델 / 전제 조건
공격자는 PyPI 의존성 혼동, 침해된 패키지, Pickle 등으로 악성 ML extension을 피해 환경에 설치시켜야 한다. extension은 피해 프로세스와 같은 사용자 권한으로 실행되고 별도 네트워크 egress를 쓰지 않는다. 협력 공격자는 secret을 알고 단일 poison sample을 넣거나 모델 API를 질의할 수 있다. ONNX Runtime은 이름 있는 gradient·weight buffer를 폭넓게 제공하지만 PyTorch hook과 TensorRT plugin은 관찰 범위가 더 제한된다.
비판적 검토 / 아쉬운 점
- 침투 전제와 영향의 분리: in-process native extension 설치는 이미 강한 공급망 침해다. 그 권한이면 파일·credential 탈취도 가능하다. 논문의 고유 기여는 초기 RCE가 아니라 egress 없는 tensor 내부 기생과 ML 특화 은닉성이다.
- runtime 간 일반화: 가장 강한 실험은 ONNX Runtime의 TrainingSession 내부 buffer 접근에 기대며 PyTorch·TensorRT는 표면이 다르다. 동일 공격이 모든 runtime에서 같은 능력을 갖는다고 읽으면 안 된다.
- black-box 유출 비용: behavioral channel은 학습 corpus의 5~15%에 trigger를 넣고 300회 반복한다. “낮은 통제”라 해도 데이터 pipeline에 상당한 쓰기 능력이 필요하다.
- 생산 실험의 독립성: ORTModule 비교는 같은 checkpoint·학습을 바탕으로 공격 유무를 비교해 구현 등가성은 보이지만, 독립 반복의 분산 증거는 약하다.
- 경제적 가치 과장 가능성: 훔친 hyperparameter의 우수성을 무작위 default와 비교한 부분은 업계의 잘 튜닝된 baseline을 대표하지 않는다.
핵심 Root Cause
깨진 불변조건은 “서명·허용된 runtime extension은 자신에게 필요한 tensor만 보고 선언된 연산만 한다”는 가정이다. 실제 확장 API와 zero-copy buffer는 권한을 세분화하지 않고 그래프 실행 문맥의 weight·gradient·activation을 공유한다. 실행 전 정적 그래프와 파일 hash가 같아도 런타임의 in-place 변조·상태 유지가 결과를 바꿀 수 있다.
핵심 공격 원리
트로이는 tensor를 관찰하고, 그래프 내부 연산으로 조건을 계산하며, buffer를 in-place 수정하고, 여러 batch에 걸쳐 replay 상태를 유지한다. backdoor에서는 드문 poison gradient를 저장·확대해 반복 재생한다. white-box 유출은 14비트 hyperparameter payload를 weight carrier에 숨기고, black-box는 trigger-codeword 행동으로 값을 인코딩해 API 질의로 복구한다.
공격 흐름
- 악성 또는 침해된 runtime extension을 의존성·모델 배포 경로로 설치한다.
- optimizer/operator/provider로 정상 등록돼 graph 실행에 참여한다.
- 목표 tensor와 학습 상태를 관찰해 활성 조건을 찾는다.
- replay·scaling·steganographic embedding 또는 gradient noise를 실행한다.
- 정적 모델 파일과 네트워크 egress를 바꾸지 않은 채 결과를 조작하거나 비밀을 모델에 심는다.
- 협력 공격자가 checkpoint 또는 소수 API 질의로 정보를 복구한다.
성공 조건 / 실패 조건
악성 확장 설치와 로딩, 필요한 tensor 접근, 학습 중 지속 실행, poison·secret 또는 질의 채널이 필요하다. extension allowlist·서명·격리, 최소 권한 tensor capability, runtime graph/event attestation, 독립 replay 비교가 있으면 실패 가능성이 커진다. PyTorch/TensorRT에서 필요한 buffer가 노출되지 않거나 학습 재현성이 낮아 carrier가 손상되면 일부 기법이 실패한다.
연구진의 실험 환경
backdoor는 RTX A6000에서 CIFAR-10·CIFAR-100·ImageNet과 ResNet-18, BadNet·WaNet을 사용해 3개 seed로 평가했다. poison 비율은 10%, 5%, 0.5%, 단일 sample이고 replay k=200, scaling s=5, 유효 증폭 20%다. white-box 유출은 5개 언어 모델×4개 데이터셋의 19개 유효 구성, 3 seed로 총 57회 진행했다. 생산형 실험은 ORTModule 1.19.2의 TrainingSession::RunForwardBackward에 hook했다.
주요 실험 결과
단일 poison에서 BadNet ASR은 CIFAR-10 0.3→97.2%, CIFAR-100 0.2→94.7%, ImageNet 0.1→92.9%; WaNet은 3.2→97.7%, 1.2→96.1%, 1.2→92.0%였다. white-box 57회는 최대 perplexity 변화 0.0024, bit error rate 0이었다. black-box는 9회 API 질의로 BER 0을 보고했지만 corpus 5~15% trigger 주입과 300회 반복이 필요했다. ORTModule에서 CIFAR-10 0.3→97.1%, CIFAR-100 0.3→94.8%, ImageNet 0.1→92.8% ASR이었다. matched filter는 batch당 1ms 미만, replay buffer는 CIFAR 약 2.4MB, ImageNet 약 120MB였다.
실제 발견된 취약점 / 사례
ONNX Runtime 1.19.2에서 raw gradient·weight buffer에 접근하는 production-style prototype을 구현했다. ClamAV 3,642,682개 signature, Malcat 2,305개, YARA 12,549개 rule과 LOKI/CAPA에서 관련 경보가 없었고, coarse runtime activation/timing detector ROC-AUC는 0.492였다. 이는 기존 규칙의 coverage gap을 보여주지만 모든 보안 제품에 대해 탐지 불가를 증명하지는 않는다.
저자 주장 vs 실제 증명 범위
backdoor 증폭과 white-box recipe 유출은 반복 수치와 코드로 강하게 뒷받침된다. CIA triad 전체 위협이라는 결론 중 availability·bit-flip·sabotage는 보조 실험의 비중이 더 크다. “ML infrastructure 전반”은 여러 runtime의 primitive를 분석했다는 뜻이지 동일 end-to-end Trojan을 모든 runtime에서 완전히 재현했다는 뜻은 아니다.
기존 공격 / 기존 점검 방식과의 차이
일반 모델 Trojan은 모델 파일이나 데이터에 payload를 남긴다. AiSPY는 실행 중 확장이 tensor를 변조해 정적 graph node 수와 checkpoint 검사를 통과한다. 네트워크 DLP도 egress가 모델 weight나 행동에 숨겨져 놓친다. 따라서 package scan뿐 아니라 runtime capability와 tensor write provenance를 봐야 한다.
연구의 한계와 주의해서 볼 부분
악성 extension 설치 경로의 실제 성공률은 측정하지 않는다. GPU·모델·runtime 버전 범위가 제한되고 대규모 분산 학습, mixed framework, quantization 환경은 충분히 다루지 않았다. signature scan 결과는 제출 시점의 rule set에 국한된다. black-box 채널은 데이터 주입량이 커 운영 anomaly로 잡힐 여지가 있다.
공개 PoC / Exploit / Tool / Artifact 분석
공식 GitHub 저장소는 공개 상태이며 AiSPY_ONNX, BackDoor_Attack, Hessian_Bit_Flip_Attack, Hyperparameter-Stealing, Sabotage_Attack 코드를 제공한다. Python 3.10+, CUDA 12.x, PyTorch 2.1+, ONNX Runtime 1.17+ 등이 필요하며 LLaMA-2-7B 실험은 인증된 Hugging Face token과 48GB급 GPU를 요구한다. 저장소는 19개 commit과 구체적 실행 명령을 제공하지만 README는 일부 backdoor reproduction path를 “under development”라고 명시하므로 모든 논문 결과가 동일 성숙도로 재현되는 것은 아니다.
레드팀 / 모의해킹에서 어떻게 활용할까
격리된 학습 job에서 canary extension에 최소 관찰 기능만 넣고 어떤 tensor가 노출되는지 capability map을 만든다. graph hash가 같아도 gradient·weight 결과가 독립 clean runner와 달라지는지 비교한다. 실제 secret 대신 canary bit를 쓰고 외부 네트워크·공용 model registry 업로드는 금지한다. 예상 밖 파일 접근이나 데이터셋 변화가 발생하면 즉시 중단한다.
실제 점검 시 추가할 체크리스트
- custom op·optimizer·execution provider를 서명·allowlist하는가
- extension별 tensor read/write capability를 최소화하는가
- lockfile·wheel hash·native shared object provenance를 검증하는가
- 정적 graph뿐 아니라 runtime operator 등록과 buffer write를 기록하는가
- 동일 seed·입력의 독립 trusted runner 결과를 비교하는가
- 학습 corpus의 반복 trigger와 비정상 sample 증폭을 탐지하는가
- checkpoint 행동 채널과 weight steganography를 배포 전에 검사하는가
실무 가치 평가
MLOps·모델 공급망 팀에 가치가 높다. 특히 “악성 패키지가 설치됐을 때 무엇을 할 수 있는가”를 일반 RCE가 아닌 ML state 관점에서 구체화한다. 우선순위는 확장 설치 방지와 provenance에 두고, 이후 runtime attestation과 독립 replay로 잔여 위험을 줄여야 한다.
결론
ML runtime extension은 사실상 모델 실행의 특권 플러그인이다. 파일 hash·network monitoring만으로는 in-memory tensor Trojan을 잡기 어렵다. 설치 출처 통제, 세분화된 runtime 권한, 실행 중 provenance와 독립 결과 검증이 함께 필요하다.


댓글