- Source: arXiv cs.CR 2609.12001
- Authors: Rohit Taneja, Travis Weber
- Original URL: https://arxiv.org/abs/2609.12001
- Archived original:
원문.pdf - SHA-256:
ae352ce00ea656d78168449360920de947f6f877b670d001c03db28088b0f898 - Tags: AI Agent, Skill, Runtime Governance, Authorization, Tool Execution, Policy Enforcement, ClawHub
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
이 연구의 메시지는 명확하다.
“이 skill이 악성인가?”와 “이 agent action을 이 조직의 이 머신에서 지금 허용해도 되는가?”는 서로 다른 질문이다.
Agent skill registry는 publish-time에 skill을 검사한다.
하지만 깨끗한 skill이라도 다음과 같은 정상 문서를 포함할 수 있다.
공식 vendor installer를 network에서 내려받아 shell로 실행이는 malware가 아닐 수 있다. 하지만 금융사나 규제 환경에서는 autonomous agent가 unattended 상태로 실행하면 정책 위반일 수 있다.
연구진은 66,192개의 public ClawHub skill version을 분석해, registry scanner와 judge가 모두 clean으로 평가한 것 중 705개 skill / 135개 publisher가 CIS Control 2.7 및 NIST SP 800-53 CM-11 관점에서 많은 운영자가 금지할 수 있는 행위를 문서화하고 있음을 보였다.
또한 static documentation과 실제 agent execution 사이의 간극도 측정했다.
- 39개 skill을 실제 agent가 sandbox에서 수행
- 실행된 command 144개
- 문서와 verbatim 동일한 command는 2개뿐
- 34.7%는 문서의 어떤 code block에도 없던 consequence class
즉 registry가 scan한 artifact는 runtime action의 완전한 upper bound가 아니다.
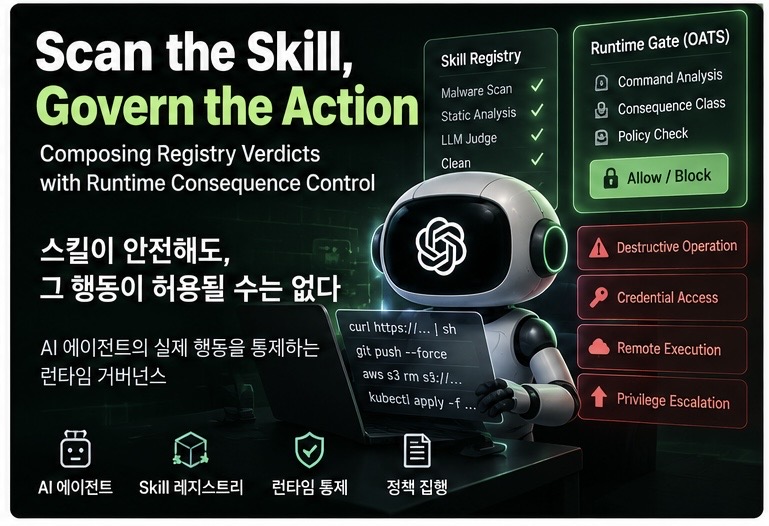
이에 연구진은 OATS(Open Agent Trust System)라는 runtime gate 설계를 제안한다.
연구 배경
Skill registry 보안은 전통적인 software supply-chain scan과 유사하다.
publish/install 전:
- VirusTotal
- static analyzer
- capability scanner
- LLM judge
- provenance/moderation context
등으로 artifact를 검사한다.
OpenClaw의 기존 measurement에서는 scanner 간 overlap 자체가 낮았다.
논문은 이것을 “scanner 품질이 나쁘다”라고 보지 않는다.
각 scanner가 서로 다른 risk surface를 보는 것이고, 더 근본적인 문제는 publish-time artifact verdict만으로 runtime authorization을 대신하려는 것이라고 본다.
은행에 비유하면:
KYC를 계좌 개설 때 한 번 했다고
400일 뒤 모든 송금을 무조건 허용하지는 않는다.
Skill scan과 tool-call authorization도 같은 관계라는 주장이다.
공격 모델 / 전제 조건
논문은 전형적인 “악성 skill이 agent를 장악한다”만 다루지 않는다.
오히려 더 약한 조건을 본다.
- skill 자체는 clean일 수 있음
- publisher도 정상일 수 있음
- 문서 내용도 정당할 수 있음
- agent가 문서를 정상적으로 따라갈 뿐일 수 있음
하지만 agent가 실제로 결정한 구체적 action이 operator policy에 맞지 않을 수 있다.
Threat surface는:
Skill documentation
→ LLM interpretation/planning
→ concrete tool call / shell command
→ real machine consequence
이다.
공격 또는 사고는 skill이 악성일 때뿐 아니라:
- agent가 문서를 다르게 해석
- command를 합성/변형
- 환경에 맞춰 추가 행동
- 정상 기능이 조직 정책과 충돌
하는 경우에도 생긴다.
핵심 Root Cause
1. Artifact property와 action authorization을 같은 것으로 취급
“malicious/clean”은 artifact의 속성이다.
하지만 “permitted/blocked”는:
- operator
- machine
- resource
- action class
- 현재 trust history
- 조직 policy
에 따라 달라진다.
따라서 같은 skill도:
개인 개발 PC → 허용
금융사 production host → 금지
가 동시에 맞을 수 있다.
2. Static document는 runtime command의 완전한 표현이 아님
LLM agent는 documentation을 그대로 복사하지 않는다.
실제 실행 시:
- 경로 변경
- command 조합
- 환경 탐색
- package 설치
- 추가 tool call
등을 생성한다.
따라서 문서만 scan하면 agent가 합성한 consequence를 놓친다.
3. Runtime control이 너무 자주 물으면 결국 꺼짐
모든 action마다 human approval을 강제하면 보안성이 높아 보이지만 friction이 커져 결국 operator가 gate를 비활성화할 가능성이 커진다.
그래서 논문은 “언제 충분히 신뢰해서 자동 승인으로 승격할 것인가”까지 policy 문제로 다룬다.
핵심 공격 원리
OATS는 “skill이 안전한가”를 재판정하지 않는다.
agent가 action을 실행하기 직전 구체적 command를 consequence class로 resolve한다.
개념적으로:
command/tool action
→ deterministic resolver
→ consequence class
→ (resource, class)별 trust ledger
→ operator policy / promotion state
→ allow / hold / block
resolver에는 model이 decision path에 없다.
논문 버전의 resolver는 33개 consequence class를 사용하며 예시는:
- generic shell execution
- remote execution
- credential access
- destructive operation
- secret/IAM change
- deploy
- CI/workflow
- repository operation
- protected merge
- computer-use action
등이다.
어떤 rule도 매칭되지 않는 command를 “unknown → allow”로 흘리지 않고 generic shell_exec로 분류한다.
즉 classification gap이 곧 fail-open으로 이어지지 않게 설계했다.
공격 흐름
이 논문은 offensive exploit chain보다 control failure chain을 보여준다.
Registry에서 skill clean 판정
→ 사용자가/agent가 skill 실행
→ LLM이 documentation을 바탕으로 실제 행동 합성
→ runtime command가 documentation의 literal/code-block 범위를 벗어남
→ publish-time scanner는 이미 끝난 상태
→ 별도 runtime gate가 없으면 조직 정책상 금지된 consequence도 실행 가능
OATS가 있으면:
concrete action 직전
→ deterministic consequence resolution
→ resource/class trust 확인
→ high-risk면 block
→ 아직 trust 부족이면 hold
→ 충분한 evidence가 쌓인 low-risk class만 unattended allow
로 바뀐다.
성공 조건 / 실패 조건
Runtime gate가 효과적인 조건
- tool call이 실제 execution 직전에 interception 가능
- action을 문자열/structured request로 관찰 가능
- consequence classifier가 해당 semantics를 충분히 인식
- 정책이 resource/class 단위로 표현 가능
- bypass되지 않는 enforcement point 존재
Gate가 놓치는 조건
연구진도 자신의 한계를 명확히 적는다.
가장 중요한 것은 harm가 하나의 suspicious action으로 나타나지 않는 경우다.
예:
- 정상 API call 여러 개를 조합해 harmful outcome 생성
- hardcoded recipient처럼 command class는 정상인데 대상만 악성
- 과도한 scope의 정상 operation
- 사용자 설득/사회공학처럼 machine action 자체는 benign
즉 action-level gate는 semantic end-goal detector가 아니다.
연구진의 실험 환경
ClawHub corpus
- public skill version: 66,192
- registry security signal과 비교
clean으로 판정됐지만 policy상 문제 가능 action을 문서화:
- 705 skill
- 135 distinct publisher
이 중 한 publisher가 506개를 차지하므로 연구진은 “705 independent publisher decision”처럼 과장하지 않는다.
Manual audit
- detector finding 중 100개 수동 감사
- precision: 92%
- 95% CI: 84.8%–96.5%
- true positive 중 malicious intent marker는 찾지 못함
즉 이것이 바로 논문의 주장이다.
악성이 아닌데도 금지될 수 있다.
Live agent study
- skill 39개
- agent 1개
- sandbox
- command 144개
결과:
- documentation에 verbatim 존재: 2개
- code block에 없던 consequence class: 34.7%
Runtime gate study
- registry-cleared skill 53개
- 문서상 clean record로 자동 trust를 얻지 못하는 action 포함
- agent가 해당 action에 실제 도달: 23개
- gate: 23/23 hold 또는 block
주요 실험 결과
Corpus 결과
705개의 clean skill이 정책상 금지 가능 action을 문서화했다.
대표 분포에는 remote-code execution 성격의 동작이 큰 비중을 차지했고, credential access, destructive operation, protected merge, workflow trigger 등도 관찰됐다.
한 publisher가 506/705를 차지하므로 raw count와 publisher diversity를 같이 봐야 한다.
Runtime documentation gap
144 command 중 2개만 문서 그대로였다.
더 중요한 수치는 50/144 = 34.7%가 문서 code block에 없던 consequence class였다는 점이다.
즉 exact command signature scan만으로 runtime behavior를 예상하는 것은 약하다.
Gate latency
논문이 측정한 current CLI hook 기준 runtime decision은 대략:
- median 약 67.6ms
- 대부분 process spawn 비용
재측정에서도 200개 sequential command에서 비슷한 수십 ms 수준을 보였다.
즉 interactive agent tool call 앞에 넣을 수 있을 정도의 latency를 주장한다.
Action equivalence benchmark
공격/우회 관점에서 중요한 결과다.
연구진은 같은 의미를 유지하면서 command 표현을 바꾼 64개 case / 9개 technique benchmark를 공개했다.
자신들의 resolver 성능은:
- macro average: 52%
- micro average: 75%
에 불과하다.
이 수치를 숨기지 않고 공개한 점은 좋다. 즉 현재 resolver도 obfuscation/rewriting에 상당한 blind spot이 있다.
실제 발견된 취약점 / 사례
이 연구는 특정 CVE보다는 runtime governance gap을 실증한다.
가장 직관적인 예는 정상 vendor installer다.
network에서 script 다운로드
→ 즉시 shell 실행
이 행위는 vendor가 악성이라는 의미가 아니다.
그러나 CIS/NIST policy 관점에서 unattended agent가 검토되지 않은 script를 직접 실행하는 것은 막아야 할 수 있다.
따라서 registry가 clean이라고 한 판단과 runtime gate가 hold/block하는 판단은 서로 모순이 아니다.
각자 다른 predicate를 평가한다.
저자 주장 vs 실제 증명 범위
강하게 보여준 것
- clean skill에도 operator policy상 금지 가능한 action이 상당수 존재
- static skill documentation과 실제 agent command 사이에 큰 차이가 존재
- concrete execution 직전 gate가 실제 high-risk action을 intercept 가능
- deterministic resolver를 model decision path 밖에 둘 수 있음
- flat approval-count policy는 사용자가 말한 risk tolerance를 통계적으로 충분히 반영하지 못할 수 있음
주의할 점
- live study는 agent 1개 / 39 또는 53 skill 수준으로 범용 agent ecosystem 전체를 대표하지 않는다.
- 23/23 차단은 “모든 공격 차단률 100%”가 아니다.
- resolver obfuscation benchmark macro 52%라는 명확한 한계가 있다.
- 연구는 authors의 commercial product와 연결돼 있다.
- resolver 핵심 predicate 구현은 완전히 공개된 source가 아니다.
- malicious intent detection을 대체하지 않는다.
기존 공격 / 기존 점검 방식과의 차이
기존 agent skill security는 주로:
skill artifact
→ malicious?
→ suspicious?
→ excessive capability?
를 본다.
이 연구는 다음을 추가한다.
실제 action
→ 이 operator가 이 resource에서 이 consequence를 지금 허용했나?
즉 software supply-chain scan과 EDR/application control의 관계처럼 pre-execution screening + runtime enforcement의 조합을 주장한다.
연구의 한계와 주의해서 볼 부분
Resolver 우회 가능성
64-case semantics-preserving rewrite benchmark에서 macro 52%다.
따라서 shell syntax, quoting, indirection, encoded command, wrapper 등의 equivalence class를 완전히 cover하지 못한다.
Human-readable transport 문제
내부 class는 structured한데 hook의 출력이 prose라 measurement script가 string split으로 class를 복구하는 부분이 있다.
연구진 스스로 stable machine-readable class ID가 필요하다고 인정한다.
Non-action harm
행위가 단일 high-risk command로 나타나지 않으면 놓칠 수 있다.
Vendor evaluation bias
연구진이 자신들의 control product를 평가한다.
논문은 이를 숨기지 않으며 competing implementation 비교가 없다는 점을 명시한다.
공개 PoC / Exploit / Tool / Artifact 분석
이 논문은 공개 artifact가 비교적 잘 갖춰져 있다.
공개 repository
https://github.com/pheo-ai/open-agent-trust-system
논문 재현 script, profile, live-agent study 관련 자료가 제공된다.
Public security-signal data
ClawHub security signal dataset을 이용해 corpus study를 재현할 수 있도록 안내한다.
Package
pheo-oats0.5.3 기준으로 논문 수치 측정
Released harness / records
- live agent study harness
- per-command JSONL record
- Dockerfile
- 64-case action-level governance benchmark
등이 공개된 것으로 논문에서 설명된다.
단, 중요한 한계가 있다.
resolver의 핵심 predicate implementation 자체는 proprietary라서 classification logic을 source level로 완전히 감사할 수는 없다.
따라서 artifact는 “논문 실험 재현성”은 높이지만 “핵심 정책 engine의 완전한 open-source 검증”까지 제공하는 것은 아니다.
레드팀 / 모의해킹에서 어떻게 활용할까
AI agent / MCP / skill / plugin 보안 점검에서는 이제 두 층을 분리해서 테스트하는 게 좋다.
1. Registry/install-time
- malicious instruction
- dependency
- provenance
- prompt injection
- excessive capability
- secret harvesting
2. Runtime
실제 agent가 내놓은:
- shell
- filesystem
- Git
- CI
- IAM
- cloud deploy
- browser/computer-use
action이 operator policy에 맞는지 검증한다.
특히 레드팀에서는 clean skill을 일부러 사용해서도 위험 action을 유도할 수 있는지를 보는 테스트가 중요하다.
왜냐하면 실제 조직은 “trusted marketplace skill”에 더 느슨한 approval policy를 적용할 가능성이 있기 때문이다.
실무 가치 평가
★★★★★ — 매우 높음
AI agent 보안에서 매우 실용적인 논문이다.
특히 다음 한 문장이 핵심이다.
Clean ≠ Permitted.
agent ecosystem은 기존 package security와 다르게 artifact가 그대로 실행되는 것이 아니라 LLM이 artifact를 해석해 새로운 action을 합성한다.
따라서 artifact scan만 강화하는 것으로는 구조적으로 부족하다.
레드팀이나 기업 agent platform 설계에서는 앞으로:
Artifact trust
+
Runtime action authorization
+
Outcome/behavior monitoring
을 별도 계층으로 보는 것이 적절하다.
결론
이 논문은 “더 좋은 악성 skill scanner”를 제안하지 않는다.
오히려 scanner만으로 해결하려는 문제 정의 자체를 분리한다.
Registry:
이 artifact가 malicious한가?

Runtime gate:
이 concrete action이
이 operator / resource / policy에서
지금 허용되는가?
두 질문은 동시에 필요하고 서로 대체할 수 없다.
AI agent 모의해킹에서는 trusted skill을 대상으로도 runtime consequence escalation 시나리오를 반드시 넣어볼 가치가 있다.


댓글