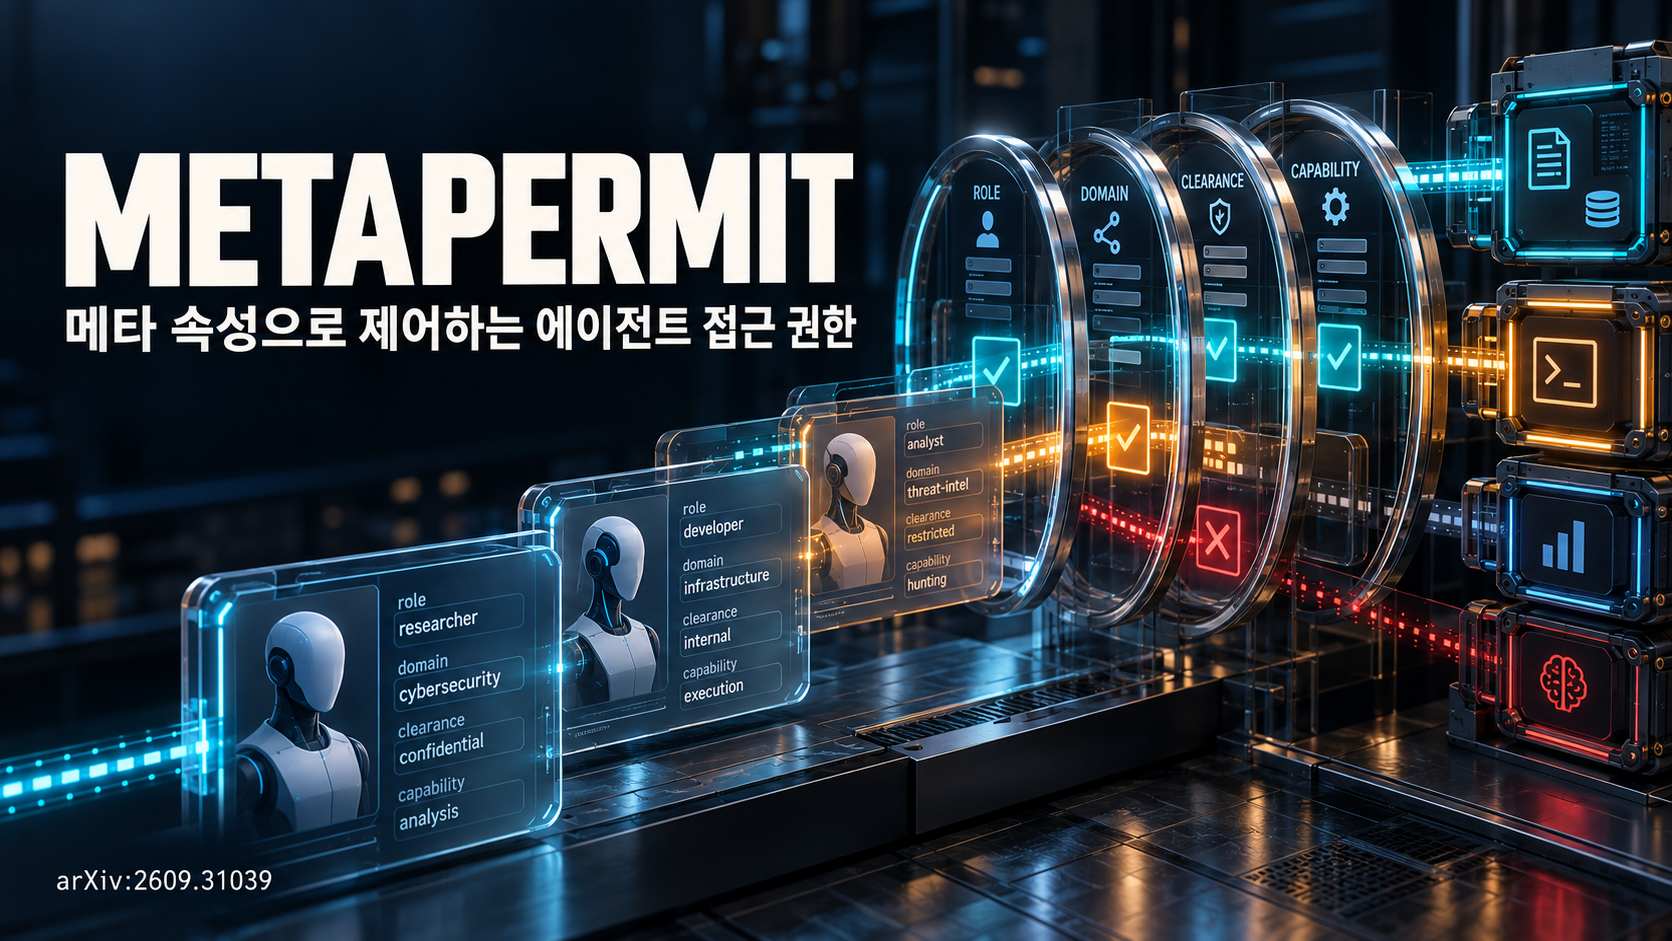
- 원문: arXiv 2609.31039
- 저자: Hanzhang Ma, Ali Hariri, Tianxiang Shen 외 9명
- 공개일: 2026-09-25
- Tags: LLM에이전트, 접근제어, 프롬프트인젝션, 도구호출, 메타속성, 정책엔진, AgentDojo, AgentDyn, 감사가능성, 최소권한
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
MetaPermit은 LLM이 도구 호출의 의미를 해석하되 최종 허용·거부는 고정 정책이 결정하도록 역할을 분리한 접근 제어 프레임워크입니다. 사용자 의도와 실행 문맥, 제안된 도구 호출의 관계를 다섯 개의 typed meta-attribute로 축약하고, 불완전하거나 잘못된 출력은 deny-by-default로 처리합니다.
AgentDojo와 AgentDyn의 1,509개 task-pair에 다섯 공격 템플릿을 적용한 7,545회 공격에서 MiniMax-M2.7은 공식 checker 기준 ASR 0.08%, 실행 인지 재판정 기준 0%, Qwen3-235B는 0%를 기록했습니다. 대신 정상 과제 성공률은 무방어 대비 약 9–12%p 낮아져 보안과 utility의 교환비가 분명합니다.
연구 배경
정적 allowlist는 열린 자연어 과제의 모든 의도를 미리 열거할 수 없고, LLM에게 직접 “이 호출을 허용해도 되는가”를 물으면 비결정성과 prompt injection 취약성이 남습니다. MetaPermit은 의미 추론을 제거하지 않고 그 결과를 제한된 속성 공간으로 변환해, 최종 판정이 사람이 검토 가능한 규칙에서 나오도록 설계합니다.
공격 모델 / 전제 조건
공격자는 검색 결과·메일·문서 등 tool-returned content를 통제해 간접 prompt injection을 삽입할 수 있지만 사용자 요청, 도구 구현, 정책, 런타임은 바꾸지 못합니다. 모든 도구 호출과 인자가 실행 전에 게이트를 통과한다는 complete mediation을 전제하며, 방어용 LLM 자체는 공격 텍스트를 볼 수 있습니다.
공격자는 인증된 사용자일 필요가 없고 피해자가 오염된 외부 콘텐츠를 에이전트에게 처리하게 하면 됩니다. 반대로 게이트 바깥의 직접 API, shell, 브라우저 또는 플러그인 경로가 존재하면 이 논문의 보장은 적용되지 않습니다.
비판적 검토 / 아쉬운 점
우선 “결정론적 정책”은 동일한 meta-attribute vector에 대해서만 결정론적입니다. 속성을 생성하는 LLM은 50개 요청을 20회 반복했을 때 완전히 같은 vector를 낸 비율이 6%에 불과했으므로, 최종 verdict 안정성 42%가 직접 guard의 32%보다 낫지만 운영상 충분하다고 보기 어렵습니다. semantic inference를 별도 모델·다수결·형식 검증으로 보강한 비용 실험이 필요합니다.
둘째, MiniMax의 공식 ASR 0.08%는 여섯 positive가 실제 tool execution이 아니라 checker가 내부 reasoning 문자열을 오인한 artifact였고, 실행 인지 재판정은 0%였습니다. 이는 방어가 더 좋다는 뜻이지만 benchmark checker 의존 결과를 그대로 제품 위험률로 읽으면 안 됩니다.
셋째, utility 하락이 작지 않으며 특히 모호하고 동적인 과제에서 정책의 보수성이 정상 흐름을 막을 수 있습니다. 실제 조직 도구, 장기 세션, 다중 agent delegation, 사용자의 부분 승인과 정책 변경을 포함한 실험이 있어야 확장성 주장이 보강됩니다.
핵심 Root Cause
근본 원인은 자연어 의미 판단과 권한 부여를 하나의 생성 모델 verdict에 결합하거나, 반대로 정적 도구 이름만으로 권한을 판단하는 데 있습니다. 깨진 보안 불변조건은 “실행되는 각 호출은 현재 사용자 의도에 명확히 대응하고, 도구와 입력이 그 의도에 정렬되며, 위험과 모호성이 정책 한계 안에 있어야 한다”입니다.
MetaPermit은 LLM을 trusted policy author가 아니라 제한된 사실 추출기로 낮춥니다. intent_is_action, clarity, risk, tool_alignment, input_alignment 같은 유한 속성을 만든 뒤 고정된 우선순위 규칙이 최종 권한을 결정합니다.
핵심 공격 원리
간접 prompt injection은 외부 콘텐츠의 지시를 사용자의 권한 있는 의도로 가장해 공격자가 원하는 도구와 인자를 호출하게 합니다. 직접 LLM guard는 설득 가능한 자연어 판단자이지만, MetaPermit에서는 하나의 속성이 흔들려도 다른 정렬 속성과 deny 규칙이 독립적으로 차단할 수 있습니다.
white-box probe 95개에서 공격은 risk 속성을 16.8% 바꿨지만 tool_alignment와 input_alignment가 각각 94/95, 95/95를 막아 단 하나도 허용되지 않았습니다. 방어의 실질적 강점은 단일 yes/no 판단이 아니라 중복된 구조적 차단 신호에 있습니다.
공격 흐름
- 에이전트가 정상 사용자 과제를 수행하면서 공격자가 조작한 tool output을 읽습니다.
- 주입 지시가 후속 도구 호출과 인자를 계획에 삽입합니다.
- MetaPermit inference module이 사용자 의도·문맥·호출 관계를 다섯 속성으로 변환합니다.
- parser와 type checker가 완전성을 검사하고, 고정 정책이 순서대로 allow 또는 deny를 결정합니다.
- 거부 시 구조화된 이유가 agent에 반환돼 안전한 재계획을 유도하고, 허용 시에만 실제 tool이 실행됩니다.
성공 조건 / 실패 조건
공격은 inference model이 위험과 불일치를 모두 정상으로 오분류하고 고정 정책의 허용 조합을 만족할 때 성공합니다. 정책이 해당 도구·인자 효과를 중재하지 않거나, 사용자 의도가 이미 공격 행동을 포함하거나, side channel 호출이 게이트를 우회할 때도 방어는 실패합니다.
적어도 하나의 필수 속성이 invalid·missing·misaligned로 판정되고 deny-by-default가 유지되면 공격은 실패합니다. 구조화된 feedback은 정상 과제를 대체 경로로 회복시키지만, 동일한 위험 호출을 반복하지 않도록 retry budget도 필요합니다.
연구진의 실험 환경
AgentDojo v0.1.35 suite v1.2.2의 97 tasks와 949 pairs, AgentDyn의 60 tasks와 560 pairs를 합쳐 7개 suite, 157개 no-attack task, 1,509개 pair를 사용했습니다. 다섯 attack template으로 pair당 공격을 만들어 총 7,545회 공격을 평가했습니다.
주요 모델은 MiniMax-M2.7과 Qwen3-235B-A22B-2507이며 task agent와 방어 구성요소에 같은 모델을 사용했습니다. 비교군은 무방어, CaMeL, IPIGuard이며 교차 모델 일반화는 Qwen3-8B에서 추가 확인했습니다.
주요 실험 결과
MiniMax에서 무방어 ASR/UA는 2.85%/62.77%, MetaPermit은 0.08%/53.92%였습니다. 실행 인지 감사로 여섯 checker artifact를 제외하면 악성 도구 호출은 0/7,545입니다. CaMeL은 0.27%/25.83%, IPIGuard는 0.91%/30.27%였습니다.
Qwen3-235B에서 무방어는 26.49%/62.37%, MetaPermit은 0%/50.13%, CaMeL은 0.46%/42.21%, IPIGuard는 3.14%/41.96%였습니다. Qwen3-8B 교차 실험에서는 ASR이 9.01%에서 1.50%로 83.4% 상대 감소했지만 UA도 45.6%에서 31.9%로 하락했습니다.
거부 feedback 70건에서 구조화 방식은 UA 60%, ASR 0%, recovery 50%, repeat 56.25%였고 generic은 52.86%/0%/32.5%/70%, silent는 50%/2.86%/34.88%/76.74%였습니다.
실제 발견된 취약점 / 사례
논문은 특정 상용 제품 CVE를 발견한 연구가 아닙니다. 대신 benchmark checker가 reasoning 문자열을 실행으로 오인할 수 있다는 평가 artifact와, LLM meta inference가 동일 입력에서 흔들리는 운영상 취약 지점을 확인했습니다.
저자 주장 vs 실제 증명 범위
저자의 “악성 tool call이 실행되지 않았다”는 주장은 두 주요 모델의 해당 benchmark와 실행 인지 재검증 범위에서는 입증됩니다. 또한 고정 정책이 intermediate attribute와 적용 rule을 남겨 직접 verdict보다 감사 가능하다는 점도 구현 구조로 뒷받침됩니다.
그러나 31% 더 일관적이라는 표현은 특정 반복 측정과 verdict 기준의 상대 비교이며 완전한 결정론을 뜻하지 않습니다. 현실의 모든 도구, 신규 공격, 정책 누락, 모델 공급자 변경에 대한 무공격 보장은 아닙니다.
기존 공격 / 기존 점검 방식과의 차이
CaMeL은 데이터·제어 흐름 분리를, IPIGuard는 injection 방어를 강조하지만 MetaPermit은 호출별 의미 관계를 소수의 typed attribute와 규칙으로 분해합니다. 직접 LLM guard 대비 최종 verdict를 모델에게 맡기지 않아 판정 근거를 재현하고 정책을 독립적으로 수정할 수 있습니다.
연구의 한계와 주의해서 볼 부분
저자도 semantic correctness에 대한 형식 보장이 없고, backend·serving default에 민감하며, empirical benchmark 결과라는 점을 인정합니다. AgentDyn의 utility 손실, checker artifact, 일부 설정 미기재는 재현과 실무 추정의 불확실성을 키웁니다.
추가로 속성 schema 자체가 공격면입니다. 새로운 도구 효과가 다섯 속성으로 충분히 표현되지 않거나 하나의 호출이 여러 주체·자산에 복합 효과를 내면 정책이 “정상으로 분류된 위험”을 만들 수 있습니다.
공개 PoC / Exploit / Tool / Artifact 분석
2026-09-29 기준 arXiv 원문은 접근 가능하지만, 논문 본문은 baseline의 vendored commit 정보를 “artifact에 기록”했다고만 설명하고 공식 artifact URL이나 GitHub 저장소를 제공하지 않습니다. 웹 검증에서도 저자·공식 프로젝트가 확인되는 공개 저장소를 찾지 못했으므로 현재 독립 재현 가능한 공개 PoC로 보지 않았습니다.
논문에는 CaMeL commit db62c44와 IPIGuard commit 4e686ed가 언급되지만 이는 비교 baseline 식별자이지 MetaPermit 공식 구현의 공개 증거가 아닙니다. 제3자 저장소를 임의로 보관하지 않았습니다.
레드팀 / 모의해킹에서 어떻게 활용할까
도구 호출마다 사용자 원문 의도, 호출 직전 문맥, 도구 이름, 인자, 외부 데이터의 출처를 함께 기록하고 다섯 속성을 독립적으로 변이합니다. 공격 recipe보다 어떤 속성이 잘못 정상화됐는지, 다른 속성이 이를 상쇄했는지, retry가 위험 호출을 반복하는지를 검증 기준으로 삼아야 합니다.
실제 쓰기·결제·발송 도구는 sandbox나 dry-run으로 대체하고, 게이트 우회·예상 밖 side effect·반복 재계획이 보이면 즉시 중단합니다.
실제 점검 시 추가할 체크리스트
- 모든 tool execution 경로가 동일 게이트를 통과하는가
- invalid·missing·parser error가 deny로 닫히는가
- 사용자 의도와 외부 콘텐츠 지시가 provenance로 구분되는가
- 도구 이름뿐 아니라 인자·대상·수량·수신자가 정렬 검사를 받는가
- 동일 요청 반복 시 attribute와 verdict 분산이 허용 범위 안인가
- 구조화 feedback이 정책 정보를 과도하게 노출하거나 무한 retry를 만들지 않는가
- 모델·temperature·provider 변경 시 정책 회귀 테스트가 실행되는가
- 정상 과제 실패율을 suite와 위험 등급별로 모니터링하는가
실무 가치 평가
MetaPermit은 LLM의 의미 해석 능력을 활용하면서 권한의 최종 결정을 코드로 회수한다는 점에서 실무 가치가 높습니다. 특히 감사 로그와 정책 변경 책임이 필요한 기업 agent에 적합합니다.
다만 보안 효과는 inference schema와 complete mediation의 품질에 달려 있으며 utility 손실도 무시하기 어렵습니다. 고위험 도구부터 단계적으로 적용하고 shadow mode에서 불일치·오탐 분포를 측정한 뒤 enforce로 전환하는 접근이 현실적입니다.
결론
MetaPermit은 “LLM이 이해하고 정책이 결정한다”는 책임 분리를 구체적인 런타임 구조와 대규모 benchmark로 보여줍니다. 7,545개 공격에서 확인된 낮은 실행 ASR은 강한 근거지만, 비결정적 attribute 생성과 정상 과제 성공률 하락은 남은 비용입니다.
따라서 이 연구는 완전한 prompt injection 해결책보다, 생성 모델의 판단을 제한된 증거로 사용하고 권한 부여를 고정 규칙과 감사 가능한 중간 상태로 옮기는 설계 패턴으로 평가하는 것이 정확합니다.


댓글