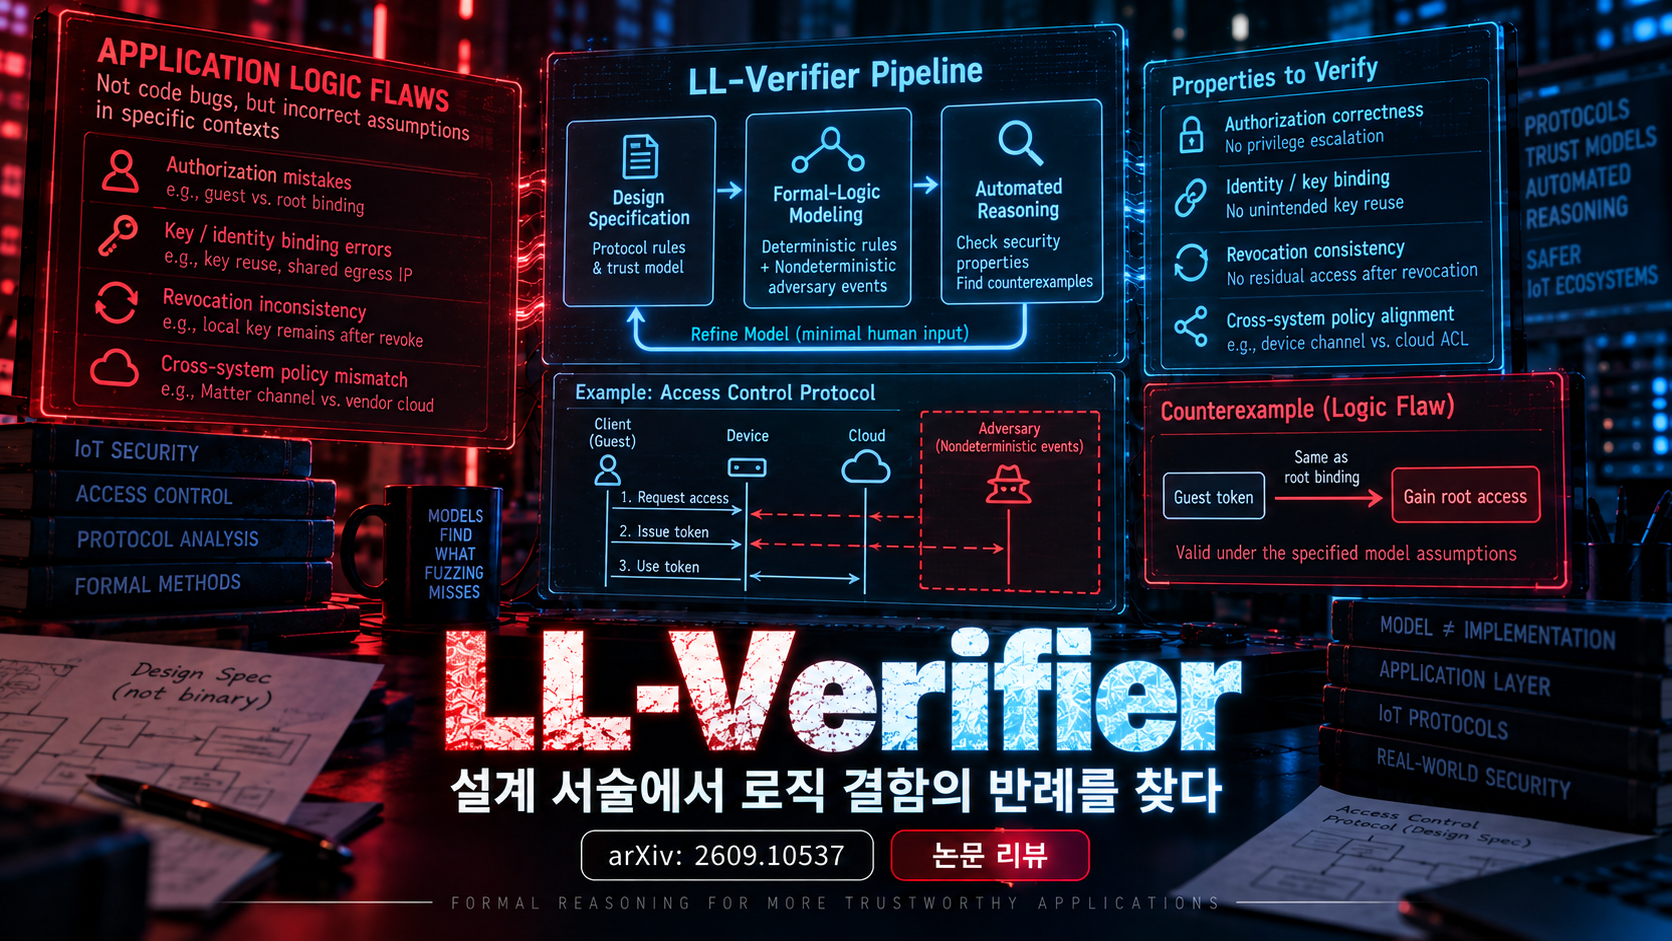
AI로 생성한 주제 설명용 이미지입니다.
- Source: arXiv cs.CR
- Authors: Yiwei Fang; Yichen Liu; Ze Jin; Haoqiang Wang; Qixu Liu; Luyi Xing
- Published: 2026-09-09
- Relevance: 핵심은 펌웨어 분석이 아니라, 자연어 프로토콜/보안 목표에서 애플리케이션 로직 모델을 자동 생성하고 모델 체킹으로 비즈니스 로직·인가·바인딩·철회 불일치를 찾는 방법이다. 평가 도메인이 IoT여도, 웹/클라우드의 소유권 이전, 게스트→루트, 철회 후 잔존 권한, 교차 채널 ACL 점검으로 바로 옮길 수 있다.
- Original URL: https://arxiv.org/abs/2609.10537
Towards Tackling Application Logic Flaws through Autonomous Formal-Logic Modeling and Automated Reasoning
한눈에 보기
관찰: 애플리케이션 로직 결함은 코드 버그가 아니라, 특정 의미 맥락에서 잘못된 가정과 설계 추론이다. 정적/동적 분석과 퍼즈로는 잘 안 잡힌다. 기존 정형 기법은 도메인 전문가가 시스템마다 모델을 손으로 만들고, 그 모델은 다른 의미 영역에 재사용되지 않는다.
보안 속성: 저자들은 암호 계층이 아니라 애플리케이션 계층 프로토콜을 대상으로 한다. 위협 모델은 Dolev-Yao 전역 도청이 아니라, 신뢰/비신뢰 주체를 도메인별로 지정한 뒤 결정적 프로토콜 규칙과 비결정적 공격자 이벤트를 분리한다. 보고된 위반은 그 가정 안의 반례다.
실제 영향: LL-Verifier를 28개 벤더·27개 장치 접근제어 프로토콜에 적용해 로직 결함 35건(그 중 신규 30건, 23개 벤더)을 찾았다. 유형은 바인딩 키 재사용, 공유 출구 IP로 키 배포, 게스트 토큰이 루트 바인딩과 동일, 철회 후 로컬 키 잔존, Matter 채널과 벤더 클라우드 ACL 불일치 등이다. CSA와 August, Philips, Tuya 등 14개 벤더가 인정하고 패치를 준비 중이라고 한다.
미충족 조건: 입력은 설계 서술이지 구현 바이너리가 아니다. 구현이 명세와 다르면 이 도구는 구현 버그를 목표로 하지 않는다. 속성 모델링 커버리지는 64.3%이고, 결함의 65.5%만 무인 검증이며 나머지는 평균 2.3회 수동 수정이 필요했다. 평가 대상이 IoT여서 펌웨어 코어 주제로 오해하기 쉽지만, 이전 가능한 값은 인가·바인딩·철회 일관성 검사다.
연구 배경
CWE-840 / OWASP Business Logic Vulnerability가 가리키듯, 로직 결함은 도메인 의미와 위협 가정에 묶여 확장이 어렵다. 폴란드 Newag 열차의 2023년 사례처럼, 제조사가 심어 둔 논리 제어가 제3자 정비에서 동작해 운행을 멈추는 식의 사고는 코드 취약점 스캐너 밖의 문제다.
정형 기법의 두 갈래가 이 공백을 메우지 못했다. DSL은 적용 범위가 좁고, Maude·Tamarin·Prolog 같은 범용 논리 언어는 유연하지만 LLM이 검증 가능한 상태기계를 정확하고 일관되게 생성하기 어렵다. 데이터 구조와 연산을 LLM이 마음대로 정하면 모델 체커가 요구하는 상태·전이 패러다임과 어긋난다. 연구 질문은 두 개다. (RQ1) 다양한 애플리케이션 프로토콜을 자율 모델링할 일반 방법. (RQ2) 맞춤 위협 모델을 프로토콜 모델에 붙여, 범위 밖 이벤트로 상태 폭발을 키우지 않으면서 결함을 찾을 언어.
이 수집에서 IoT를 핵심 주제로 고른 것이 아니다. 우선순위는 비즈니스 로직·인가·권한 상승이다. IoT는 벤더마다 의미가 다른 접근제어를 대량으로 공급하는 평가 도메인이다.
공격 모델 / 전제 조건
평가 절의 위협 모델(§4)
- 클라우드, 관리 콘솔, 장치 하드웨어/펌웨어는 정직하다.
- 공격자는 다른 사용자 통신을 도청하거나 변조하지 못한다.
- 물리 접근 직후의 리셋/바인딩은 잘 알려진 공격으로 초점을 두지 않는다.
- 한 번 접근한 뒤 떠난 다음에도 원격으로 소유자 바인딩을 깨거나 재바인딩할 수 있으면 보안 기대 위반이다.
도구가 받는 전제
- 입력: 프로토콜의 자연어 서술 + 맞춤 보안 목표. 전처리 에이전트가 규칙 / 이벤트 생성 조건 / 초기 상태 / 위협·속성의 네 조각으로 나눈다. 사람은 각 규칙에 사전조건(선택), 이벤트, 사후조건이 있는지 확인한다.
- 신뢰 주체의 규칙은 결정적(→), 비신뢰 주체의 이벤트는 비결정적(r→). 위협 모델에 명시한 규칙이 동일 전제의 프로토콜 규칙보다 우선한다.
- 보안 목표는 LTL 위반 트레이스로 쓴다. 예: 원격 공격자가 소유권을 가져감(sv1), 소유자가 아닌 주체가 장치를 켬(sv2).
성공/실패 조건: 모델이 문법·의미 가드레일을 통과하고, 지정한 위협 창 안에서 속성 부정에 대한 반례가 나오면 “그 가정 안의 로직 결함”이다. 가정 밖 물리 탈취나 암호 깨기는 보고하지 않는 것이 설계다.
핵심 공격 원리
LL-Verifier의 원리는 “LLM이 아무 논리 코드를 짜게 하지 않고, 검증 가능한 논리 상태기계(LSM)만 짜게 가드한다”는 것이다.
Les 언어와 Formal Modeling Guardrails(FMG)
- 주체: User / Device / Cloud ⊆ Principal.
- 내부 상태: <Principal | Attributes>. Attributes는 키-값 집합.
- 이벤트: $ Principal Action Principal | Arguments.
- 상태 전이 규칙: 전제 → 결론. 신뢰 여부에 따라 → 와 r→.
- 이벤트 생성 규칙: 특정 지식 상태에서 가능한 API/동작을 뽑는다. 모르는 비밀을 인자로 못 쓰게 지식을 조건으로 건다.
컴파일
- 결정적 규칙 → Maude 등식 E
- 비결정적 규칙 → 재작성 규칙 R
- (Σ, E, R)이 LSM M = (S, s0, TR, R)이 된다. 상태 s = e @ ls는 최근 이벤트와 논리 상태를 같이 담아, 상태 속성과 이벤트 속성을 모두 LTL로 쓸 수 있다.
파이프라인
- 전처리 에이전트 + 사람 확인
- AgentS가 상태 전이 규칙, 프로그램 분석기가 주체별 상태 템플릿
- AgentE가 같은 이름 공간으로 이벤트 생성 규칙
- 가드레일 에이전트가 Lark+EBNF로 문법, 반성 루프로 의미(RHS 변수가 LHS에 있는가 등) 수정. 프로토콜당 최대 3회.
- Les 컴파일러 → Maude LTL 체커. 속성 부정에 대한 공격 트레이스 출력.
iRobot RTE 예시가 원리를 보여 준다. 사용자와 장치가 같은 바인딩 키를 클라우드에 보이면 소유자가 된다. 버튼 후 장치가 새 키를 받고 클라우드에 올리며, 사용자는 bind/reset을 호출한다. 키가 장치·앱·클라우드에 남는 방식과 reset API의 효과가 결합되면, 한때 키를 본 주체가 나중에 원격으로 소유자를 지울 수 있다. 이것이 LFT 1–2의 논리이지, 암호 깨기가 아니다.
공격 흐름
인가된 점검에서 따라갈 조건열이다. 재현 레시피가 아니다.
공통 흐름
- 설계 문서·도움말·API 설명을 규칙/이벤트/초기상태/위협으로 나눈다.
- 신뢰 경계(클라우드 정직, 게스트 비신뢰, 물리 1회 등)를 명시한다.
- 주체·속성·이벤트 이름을 고정한 모델을 만든다.
- “철회 이후에도 로컬 권한이 남음”, “게스트 토큰으로 루트 바인딩” 같은 속성의 부정을 체킹한다.
- 나온 트레이스를 구현의 실제 API·상태 저장 위치와 대조한다. 모델만으로 배포 취약점을 단정하지 않는다.
평가에서 반복된 논리 패턴(웹/클라우드로 옮길 이름)
- 바인딩 키와 일반 액세스 키가 같다 → 철회 후에도 루트 승격.
- 공유 네트워크 위치(출구 IP, 같은 Wi-Fi)로 비밀을 뿌린다 → 인접 테넌트가 키를 받는다.
- 채널이 두 개(클라우드 ACL vs 로컬/Matter ACL)인데 철회가 한 채널만 지운다 → 잔존 권한.
- 장치가 증명자인 바인딩에서, 근접 주체가 키를 갈아끼운다 → 소유자가 바뀐다.
- 최신 키만 인정하지 않고 과거 키를 계속 받는다 → 게스트가 반복 바인딩.
연구진의 실험
구현: Python 2564줄, Maude 157줄. Logic-Modeling Bench는 29개 프로토콜(24 IoT/모바일 벤더 + 선행 논문 5). 프로토콜당 평균 425단어, 규칙 12, 주체 4, 속성 10.
모델링 정확도: 주체 98.3%(FP 1.7%), 속성 99.3%(FP 1.4%), 규칙 96.8%, 속성(property) 64.3%. 결함의 65.5%는 무인 검증. 실패분은 평균 2.3회 수동 수정.
어블레이션: iRobot / Aqara / August에서 공식 Maude 문법으로 직접 생성하면 런타임 실패가 나고, 규칙 27/44·속성 27/30만 커버. Les+가드레일은 실행 가능하고 의미 커버가 더 높다.
LLM 선택: GPT-4o, Grok-3, Claude-sonnet-4, DeepSeek-R1, Gemini-2.5-Pro-Preview. 주체/속성/규칙/이벤트 커버 70% 이상. 5중 4개가 사람 개입 없이 실제 결함을 내는 모델을 최소 하나 만들었다.
성능: Ryzen 5 4600H 3GHz, 16GB. 모델당 평균 462ms, 최대 메모리 75,860KB. 상태 폭발이 이 벤치 규모에서는 실용 범위였다.
실장치 확인: 신규 결함 전부 저자 소유 장치에서 PoC. 책임 공개. 이 노트는 PoC 패킷·스크립트를 재수록하지 않는다.
주요 결과
발견량: 28 벤더, 27 고유 장치, 로직 결함 35, 신규 30(23 벤더), 알려진 것 4(Google Home / SmartThings 상호운용, Kwikset / Level 협력 접근제어).
아홉 유형을 설계 실수와 프로토콜 계급으로 묶는다.
RTE P1 (사용자와 장치가 각각 비밀을 클라우드에 보임)
- LFT 1: 일시 물리 접근으로 키를 심은 뒤 원격 reset으로 소유자 기록을 지움.
- LFT 2: 장치가 이전 바인딩 키를 로컬 제어용으로 남김. 이후 원격 reset에 재사용.
- LFT 3: 클라우드가 장치와 같은 출구 IP의 아무 사용자에게 키를 전달. 캠퍼스/기업 NAT에서 경합 가능. 일부 설계는 다중 루트를 허용해 피해자가 다른 루트를 모를 수 있다.
RTE P2 (사용자가 장치에서 키를 받아 클라우드에 증명)
- LFT 4: 게스트 액세스 토큰과 바인딩 토큰이 동일. 철회 후 클라우드 manage/add류 호출로 루트.
- LFT 5: 과거 키를 계속 인정하거나, 소유자 리셋 창을 스크립트가 선점.
RTE P3 (장치가 사용자 신원이 든 키를 클라우드에 제시)
- LFT 6: 바인딩 중 근접 주체가 자신의 키로 교체. 장치가 클라우드에 그 키를 내면 소유자가 바뀜.
- LFT 7: CloudEdge 카메라, 부록.
상호운용
- LFT 8: 벤더 앱의 게스트는 바인딩을 못 하지만, Matter RTE로 장치 내부 바인딩을 만든 뒤 벤더 철회가 클라우드 ACL만 지움.
협력 접근제어
- LFT 9: 철회 후 클라우드는 원격+로컬 키를 거부하지만, 장치는 로컬 키만으로 명령을 받음. Tuya, Dyson, Xiaomi, Huawei, Philips, CloudEdge, Broadlink에서 유사.
공개 반응: CSA(Matter)와 14 벤더 인정·패치. 성능 수치는 모델 체킹이 수 백 ms라는 것이지, 전처리·LLM 호출 전체를 포함하지 않을 수 있다.
실제 발견된 취약점 / 사례
CVE 목록은 본문에 없다. 확인된 것은 설계 논리와 실장치 동작이다.
- iRobot Roomba 계열: 버튼 이후 로컬 인터페이스로 키를 읽거나 교체한 뒤, 원격 reset이 소유자를 지움. 로컬 MQTT는 클라우드 장애 시 제어용으로 키가 남는 설계와 연결된다.
- Philips Hue: 같은 출구 IP에 키를 뿌리는 웹 호환 RTE. 인접 테넌트가 RequestAccess류를 먼저 받으면 키를 가져갈 수 있다.
- Broadlink: 게스트에게 노출된 값이 바인딩 비밀과 동일. 철회 후에도 루트 승격.
- TP-Link Kasa: 바인딩 핫스팟 구간에 근접 앱이 키를 밀어 넣을 수 있음.
- Aqara + Matter: 게스트가 Matter 페어링으로 장치 ACL에 남은 뒤 벤더 앱 철회를 견딤.
- Tuya 등 CAC: 철회 후 로컬 포트 명령이 로컬 키만으로 살아 있음.
저자는 영상·트레이스를 사이트에 두었다고 한다. 인가 범위 밖의 재현은 하지 말고, 동일 논리(키 역할 혼동, 철회 불완전, 교차 채널 ACL)를 대상 시스템에서 검증하는 쪽이 이 노트의 용도다.
기존 공격과의 차이
선행 자동 로직 분석(테스트 생성, 모델 가이드)은 대체로 도메인 특화이고 수동이 크다. 암호 프로토콜용 자연어→모델 연구는 키 교환 의미에 맞춰져 있고, 임의 애플리케이션 의미를 목표로 하지 않는다. 코드에서 모델을 뽑는 연구와 달리 입력은 텍스트 설계다. VerioT, MPInspector 등은 특정 IoT 메시징에 맞춰 손으로 모델을 만든다. LL-Verifier는 언어 가드레일 + 에이전트 분할 + 맞춤 위협 모델 병합으로 “의미 불문 자동 모델링”을 주장한다. 웹 로직 블랙박스 탐지(Pellegrino/Balzarotti, Felmetsger 등)가 트래픽·상태 기계 추론에 가깝다면, 이 연구는 명세를 먼저 논리로 올린다.
연구의 한계와 주의해서 볼 부분
- 핵심 평가가 IoT다. 펌웨어 리버스나 무선 물리 계층이 주제가 아니며, 웹 앱에 그대로 돌려 35건이 나온다는 증거는 없다.
- 구현 일탈은 범위 밖이다. 명세가 안전한 구현 버그는 놓친다. 반대로 명세가 위험한 구현은 “설계 결함”으로 맞다.
- 속성 커버 64.3%는 목표 누락이 적지 않음을 뜻한다. 무인 65.5%는 나머지에 사람이 필요하다.
- “FP 없는 분석”은 정의한 위협 모델 안의 이야기다. 위협을 너무 약하게 쓰면 거짓 음성이, 너무 넓게 쓰면 비현실 트레이스가 나온다.
- LLM 환각은 가드레일로 줄이지만 제거되지 않는다. RHS/LHS 변수, 이름 불일치가 반복된다.
- 전처리에 사람이 들어간다. 완전 자동이 아니다.
- 상태 폭발은 이 벤치에서는 작았으나, 웹의 큰 세션 공간으로의 확장은 미입증이다.
- 저자 PoC는 실장치 공격 세부(패킷, 핫스팟 타이밍)를 포함한다. 이 노트는 그 재현을 복제하지 않는다.
레드팀 / 모의해킹 실무 적용
인가된 웹·API·클라우드·슈퍼앱 점검에서 가져올 것은 IoT 핫스팟 공격이 아니라 아래 분리다.
관찰: 철회 API가 200을 줘도 다른 채널의 인가 자료가 남을 수 있다.
보안 속성: “게스트는 바인딩 못 함”, “액세스 키 ≠ 루트 키”, “최신 비밀만 유효”가 모든 채널에서 같은지.
실제 영향: 게스트·위임·소유권 이전이 있는 제품에서 루트 승격, 교차 계정 바인딩, 철회 후 잔존 제어가 비즈니스 로직으로 나타난다.
미충족 조건: 클라우드 ACL만 보고 로컬·세컨더리 프로토콜·캐시된 토큰을 안 보면 LFT 8–9류가 남는다.
적용
- 대상의 바인딩/온보딩/위임/철회/소유권 이전 문서를 규칙 표로 옮긴다.
- 주체(소유자, 게스트, 클라우드, 장치/테넌트)와 비밀의 역할(바인딩 vs 세션 vs 로컬)을 나눈다.
- 각 비밀이 몇 개 채널에서 받아들여지는지 적는다.
- 철회 후 모든 채널을 다시 호출하는 인가 체크리스트를 만든다.
- 여력이 있으면 같은 표를 Les/TLA+/Alloy로 올리고, 아니면 표만으로 수동 모델 체킹을 한다.
실제 점검 시 추가할 체크리스트
- [ ] 바인딩/온보딩 비밀과 일상 액세스 토큰이 다른가. 게스트에게 전자가 노출되지 않는가.
- [ ] 철회·만료 후 예전 비밀로 루트 작업(소유자 변경, 디바이스 추가, 관리 API)이 거절되는가.
- [ ] 서버가 최신 비밀만 인정하는가. 과거 키 전부가 유효하지 않은가.
- [ ] 소유권 이전·리셋의 짧은 창에서 비소유자가 선점할 수 없게 원자적/잠금이 있는가.
- [ ] 비밀 배포가 네트워크 위치(출구 IP, 동일 Wi-Fi, 동일 홈 ID)에만 의존하지 않는가.
- [ ] 클라우드 ACL과 로컬/세컨더리 채널 ACL이 철회 시 같이 갱신되는가.
- [ ] 위임 게스트가 다른 표준 채널로 권한을 올리지 못하는가.
- [ ] 근접·동시 바인딩 경합에서 마지막 키가 임의 주체 것이면 사용자에게 보이는가.
- [ ] 리셋 API가 비밀만으로 소유자를 지우는가. 세션 소유자와의 바인딩을 추가로 요구하는가.
- [ ] 문서의 사전/사후조건이 구현 테스트와 같은가. 명세만 믿고 구현을 안 보지 않는가.
- [ ] 위협 모델에 없는 물리 탈취를 도구 출력만으로 신규 취약점이라고 쓰지 않는가.
공개된 PoC / Tool / Artifact
- 논문 / PDF: https://arxiv.org/abs/2609.10537 , https://arxiv.org/pdf/2609.10537.pdf
- 프로젝트 사이트: https://sites.google.com/view/ll-verifier/home
- 익명 아티팩트: https://anonymous.4open.science/r/LLVerifier-204C/README.md
- Logic-Modeling Bench(원문·정리문·Les 모델)는 위 사이트에 포함된다고 한다.
- Maude LTL model checker, Lark(EBNF).
- 저자 실장치 PoC·영상은 사이트에 있다. 이 아카이브는 공격 패킷을 복사하지 않는다.
결론
LL-Verifier는 애플리케이션 로직을 “사람이 도메인 모델을 새로 짜는 일”에서 “가드된 논리 언어로 올리고 맞춤 위협 안에서 체킹하는 일”로 옮긴다. 평가 숫자는 IoT 접근제어에서 나왔지만, 점검자가 가져갈 것은 바인딩 비밀과 액세스 비밀의 분리, 철회의 전 채널 적용, 위치 기반 비밀 배포 금지, 교차 표준 ACL 동기화다. 모델 체커 출력을 구현 증거 없이 취약점이라고 쓰지 말고, 문서→규칙 표→채널별 철회 재검증 순으로 쓰는 것이 안전한 실무 적용이다.
'Hack > Web' 카테고리의 다른 글
| Secrets That Survive Everything: Runtime Credential Exposure in Production Web Applications (0) | 2026.09.23 |
|---|---|
| Robot Visions: Breaking reCAPTCHA at Zero Cost and Zero Shot (0) | 2026.09.22 |
| What's in a tag name? JavaScript, apparently (0) | 2026.09.13 |
| 파일 업로드 취약점 (0) | 2025.05.26 |
| [Dreamhack] Hangul Revenge (0) | 2025.03.21 |


댓글