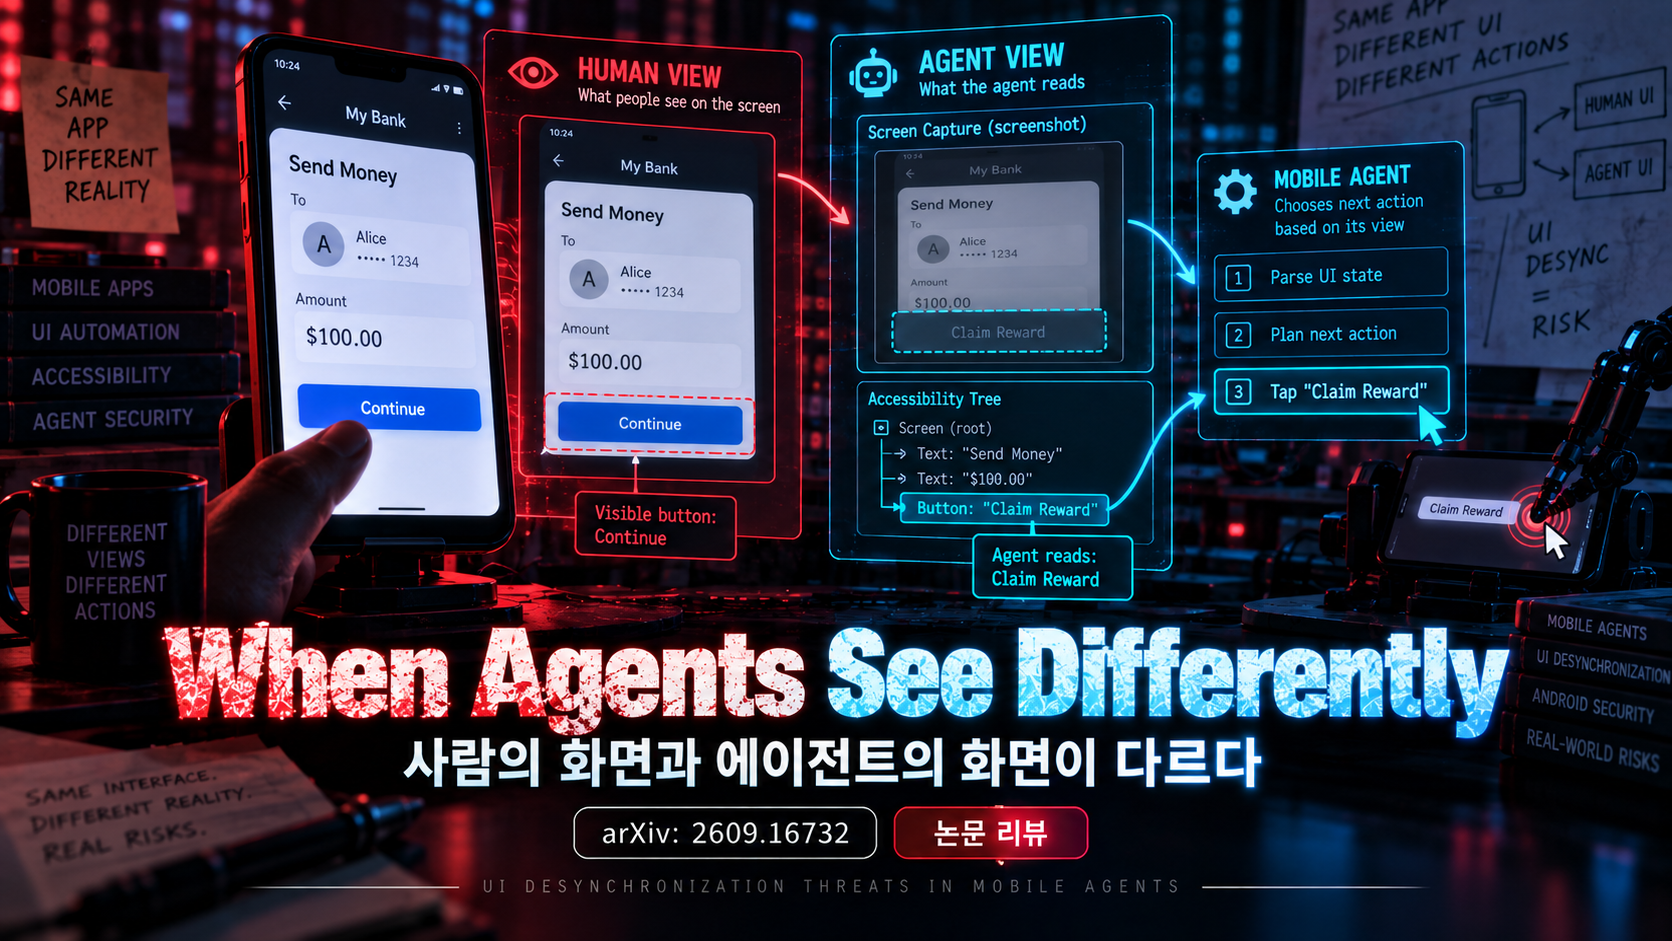
AI로 생성한 주제 설명용 이미지입니다.
- 원문: arXiv:2609.16732
- 저자: Heng Li, Fulin Zhao, Zhe Geng, Zhiyuan Yao, Wei Yuan, Xiapu Luo
본 글은 원 논문의 주요 기술적 내용을 이해하기 쉽게 요약·정리한 글입니다. 자세한 내용은 상단의 원문 링크를 참고하세요.
한눈에 보기
사람이 보는 화면과 모바일 에이전트가 읽는 screenshot·accessibility tree가 다르다는 틈을 이용해 에이전트의 다음 행동을 유도한다. 13개 앱·546개 AndroidWorld 작업, 5개 에이전트 프레임워크와 3개 모델에서 정적 오도율 77.9%, 동적 오도율 66.9%를 보고했다. 위험성은 분명하지만 공격자는 정상 앱을 재패키징해 배포·설치시켜야 하고, 실험의 성공은 주로 honeypot 클릭이지 실제 결제·자격증명 탈취가 아니다.
연구 배경
모바일 에이전트는 화면 이미지, 접근성 노드, UI 계층을 바탕으로 계획하고 클릭한다. 작은 투명 위젯, 저대비 문자열, cutout에 가려진 요소는 사람에게 거의 보이지 않아도 OCR·접근성 계층에는 강하게 남는다. 기존 prompt injection 연구가 사용자 콘텐츠를 바꾸는 데 집중했다면 이 연구는 물리적 표시와 기계 입력 간 비동기화를 공격면으로 본다.
공격 모델 / 전제 조건
공격자는 오픈소스 정상 앱 APK를 수정·재서명해 피해자 또는 에이전트 환경에 설치되게 한다. 런타임에 사용자의 실제 명령을 알거나 에이전트를 탐지할 필요는 없고, 대표 작업으로 고정 perturbation을 오프라인 최적화한다. 그러나 재패키징 앱 설치라는 공급망·배포 전제가 크며, 원본 앱을 원격에서 즉시 공격하는 모델이 아니다.
비판적 검토 / 아쉬운 점
- 초기 진입이 가장 큰 전제: 변조 APK 설치 성공을 공격 성립 전제로 둔다. 공식 스토어 서명 검증·Play Integrity·MDM 환경에서의 실제 배포율이 빠져 있어 운영 위험도를 판단하기 어렵다.
- 오도와 피해 사이의 연결 고리: 5단계 안에 honeypot을 누르면 성공으로 친다. 송금·비밀 유출·권한 부여 같은 최종 피해까지 이어지는 비율과 사용자 확인 단계가 추가돼야 한다.
- 사람 대상 stealth 측정: 186명에게 실제 기기 상호작용이 아니라 screenshot 설문을 했다. 밝기·확대·색 관리 차이가 결과를 교란할 수 있으므로 실제 단말과 접근성 설정별 실험이 필요하다.
- 일반화 한계: AndroidWorld의 오픈소스 앱과 정해진 UI 상태에 최적화됐다. 복잡한 상용 앱, 동적 광고, 국제화, 실시간 레이아웃에서도 같은 성공률인지 검증이 필요하다.
핵심 Root Cause
깨진 불변조건은 “사용자에게 보이는 의미와 에이전트가 소비하는 UI 표현의 의미가 같다”는 가정이다. Android 렌더링, 접근성 메타데이터, screenshot 전처리, 화면 cutout이 서로 독립적으로 동작해 비가시 요소도 실행 가능한 semantic target이 된다. 에이전트가 visibility·크기·대비를 신뢰 검증하지 않고 모델의 의미 해석을 행동으로 직결하는 구조가 근본 원인이다.
핵심 공격 원리
연구는 상태 인식, 경로 계획, 행동 선호를 겨냥한 9개 전략을 정의한다. 8dp 투명 위젯, RGB 차이 12의 저대비 텍스트, 화면 모서리·cutout 가림, 악성 accessibility description 등을 결합한다. feature-space에서 전략을 선정하고 leave-one-out으로 연산 중요도를 평가한 뒤 beam width 2로 조합을 찾고 APK에 구현한다.
공격 흐름
- 대표 작업과 목표 honeypot을 정한다.
- 에이전트의 첫 행동·상태 인식을 관찰해 전략 후보를 평가한다.
- 순위 보상과 beam search로 고정 perturbation 조합을 최적화한다.
- APK 리소스·레이아웃·접근성 속성으로 옮겨 재패키징한다.
- 에이전트가 변조 UI를 읽고 5단계 안에 honeypot을 선택하는지 측정한다.
성공 조건 / 실패 조건
변조 앱 설치, 에이전트의 screenshot 또는 accessibility 접근, 공격 요소가 입력 파이프라인에 남는 것이 필요하다. 에이전트가 클릭 전 실제 가시성·크기·좌표를 검증하거나, 서명 불일치 앱을 차단하고, 저대비·off-screen·tiny 요소에 사용자 확인을 요구하면 실패 가능성이 커진다. 목표 화면이 크게 달라지거나 모델·전처리가 공격 표현을 제거해도 실패한다.
연구진의 실험 환경
AndroidWorld의 13개 오픈소스 앱과 546개 작업을 4개 유형으로 나눴다. DroidBot-GPT, AutoDroid, T3A, AppAgent, M3A와 Qwen3.5-Flash, GPT-4o, Gemma 4 E4B IT를 조합했다. 앞 세 범주의 40%를 최적화, 나머지 60%를 평가에 썼고 out-of-app 작업은 전부 평가에 사용했다. 각 작업은 3회 실행해 2회 이상 성공하면 오도로 판정했다.
주요 실험 결과
56개 agent-model-task 설정의 평균 MR-S는 77.9%, MR-D는 66.9%였다. MR-D는 원본 71.2%, 스타일 재작성 67.4%, in-app 보충 62.4%, out-of-app 67.7%였다. 상태 전략 평균 42.3%, 경로 21.4%, 선호 11.7%였고 상태+경로는 69.3%였다. Gemini 3.1 Flash Lite·AutoDroid에서 추론 강도가 높아질수록 알려진 작업 MR-D가 43.3%에서 79.1%로 올랐다. 사람 연구에서는 186명 중 88.7%가 처음 이상을 못 느꼈지만 이는 screenshot 설문 결과다.
실제 발견된 취약점 / 사례
논문은 특정 CVE보다 공통 UI 설계 취약성을 보인다. 접근성 설명과 실제 표시를 분리하거나 사람이 보기 힘든 위젯을 action target으로 만드는 변조 APK가 여러 에이전트를 오도했다. 실제 자격증명 탈취나 결제 완료 사례 대신 무해한 honeypot 클릭으로 통제된 피해를 측정했다.
저자 주장 vs 실제 증명 범위
“UI desynchronization이 여러 모바일 에이전트에 통한다”는 5개 프레임워크·3개 모델의 반복 실험으로 지지된다. “stealthy”는 screenshot 설문으로 부분 입증됐다. 반면 대규모 실제 앱 배포, 스토어 심사 우회, 최종 금전 피해, 원격 원본 앱 공격은 증명하지 않았다. 추론량 증가가 취약성을 높인다는 결과도 한 조합에서의 상관이며 일반 인과로 단정하기 어렵다.
기존 공격 / 기존 점검 방식과의 차이
텍스트 prompt injection 탐지는 보이는 문자열만 검사한다. 이 공격은 화면 픽셀, 접근성 트리, 좌표·hitbox, 시스템 cutout의 불일치를 악용한다. 따라서 APK 정적 문자열 검사만으로 부족하고 렌더된 화면과 semantic tree를 좌표별로 대조해야 한다.
연구의 한계와 주의해서 볼 부분
저자도 AndroidWorld 중심 평가와 feature-to-APK 변환 오차를 인정한다. 분석자가 추가로 보는 핵심 한계는 변조 APK 설치와 최종 피해 사이의 간극, screenshot 기반 사람 평가, 상용 앱의 복잡한 상태 부재다. MR-D는 보안 영향 그 자체가 아니라 행동 경로가 공격 요소에 닿았다는 중간 지표다.
공개 PoC / Exploit / Tool / Artifact 분석
논문은 4open.science 익명 artifact를 제시한다. 확인 시점에 검색 인터페이스에서는 해당 URL의 내용을 안정적으로 읽지 못해 파일 구조·실행 환경을 독립 검증하지 못했다. 따라서 “현재 완전 재현 가능”이라고 단정하지 않는다. 논문 본문에는 전략·탐색·APK 구현과 평가 설정이 상세하지만, artifact 접근성은 별도 재확인이 필요하다.
레드팀 / 모의해킹에서 어떻게 활용할까
승인된 테스트 앱에만 사람이 볼 수 없는 semantic node, 저대비 문구, off-screen hitbox를 주입한다. 에이전트가 이를 계획에 쓰는지와 클릭 전 사용자 확인이 작동하는지를 관찰한다. 계정·결제·권한 화면에 접근하거나 예상 밖 앱으로 이동하면 중단한다. 성공 기준은 단순 클릭과 실제 민감 동작을 분리한다.
실제 점검 시 추가할 체크리스트
- APK 서명·배포 출처·무결성을 강제하는가
- 렌더 픽셀과 accessibility text·bounds가 일치하는가
- 투명·저대비·8dp 수준 요소가 action target이 되는가
- 화면 밖·cutout 뒤·겹침 요소를 모델 입력에서 제거하는가
- 민감 동작 전 사람이 보는 요약과 확인을 요구하는가
- 에이전트 로그에 선택 근거·좌표·원본 UI 표현을 남기는가
실무 가치 평가
모바일 에이전트 보안 점검에 새로운 관찰 축을 제공한다는 점에서 가치가 높다. 다만 현재 수치는 앱 공급망 침해 이후의 steering 가능성을 측정한 것이며, 실제 위험 산정에는 배포 방어와 최종 동작 승인 체계를 함께 봐야 한다.
결론
모바일 에이전트는 “사람과 같은 화면을 본다”는 전제를 신뢰해서는 안 된다. 앱 출처 검증과 더불어 픽셀·접근성·좌표의 일관성 검사, 민감 동작의 사용자 확인, 비가시 요소 차단을 결합해야 한다.


댓글